Articles · Smallem : le processeur
Ce que vaut un processeur
Premier article de la série Smallem : le processeur, qui prolonge Smallem : un LLM en Rust et CUDA, à partir de zéro.
La première série a écrit deux backends : un pour le GPU pour les calculs et celui du processeur,
Cpu<F>, qui sert qu'à vérifier l'autre : un seul thread, aucune instruction vectorielle, le
produit matriciel en triple boucle. Il est fait pour qu'on le croie, pas pour aller vite.
Et il ne va pas vite :
pas d'entraînement xl, 512 tokens    112 s        la carte : 0,16 s pour 8 192 tokens, en bf16
génération                           16 tokens/s  la carte : 984
Cette série en écrit un troisième, Fast, qui exploite vraiment le processeur de la
machine. Le processeur ne battra pas la carte à l'entraînement : il n'a ni Tensor Cores ni
milliers de threads. Mais combien vaut-il, au juste ? Et sur quoi peut-il gagner ?
Avant d'écrire une ligne d'optimisation, il faut une borne : ce que la machine peut faire au mieux. C'est l'objet de cet article.
La machine
Un Ryzen 7 7700, de la génération Zen 4 d'AMD : 8 coeurs, chacun capable de suivre deux threads à la fois (le SMT, 16 threads en tout). Chaque coeur a 32 Ko de cache L1 pour les données et 1 Mo de cache L2. Les 8 coeurs se partagent 32 Mo de L3. La mémoire principale est de 64 Go.
Zen 4 a l'AVX-512 : 32 registres de 512 bits, seize f32 chacun. Mais il exécute une instruction
de 512 bits en deux moitiés de 256 bits, sur les mêmes unités que l'AVX2. Il a aussi deux jeux
d'instructions qui nous serviront plus tard : vdpbf16ps, qui multiplie des paires de bf16, et
vpdpbusd, qui multiplie des octets.
Le maximum de calcul
L'opération qui compte est la FMA, fused multiply-add : a × b + c en une instruction,
deux opérations. Un produit matriciel n'est fait que de cela. Combien un coeur en fait-il
par cycle ?
Pour le savoir, on lui en donne autant qu'il peut en faire, sans rien d'autre : douze accumulateurs indépendants, et une boucle qui les met à jour sans fin.
unsafe
Les fonctions _mm512_… sont des intrinsèques : chacune correspond à une instruction
vectorielle du processeur. Intel les a nommées pour le C, et Rust les reprend telles
quelles dans std::arch::x86_64. Elles opèrent sur un __m512, un registre AVX-512 de 512
bits, soit seize f32. Leur nom se lit en trois morceaux : la largeur du registre
(_mm512_, ou _mm256_ pour l'AVX2), l'opération, puis le type des cases (_ps, packed
single, des f32 côte à côte, _epi8 ou _epi32, des entiers). Quatre suffisent pour
cette série :
_mm512_set1_ps(x)copiexdans les seize cases_mm512_setzero_ps()donne seize zéros_mm512_loadu_ps(p)lit seizef32consécutifs en mémoire, à une adresse quelconque (leud'unaligned)_mm512_fmadd_ps(a, b, c)calculea × b + cdans les seize cases à la fois.
Elles sont unsafe : le processeur doit avoir l'instruction. L'attribut
#[target_feature(enable = "avx512f")] autorise le compilateur à l'émettre dans cette
fonction, et le programme vérifie l'AVX-512 au lancement avant de l'appeler.
Pourquoi douze accumulateurs ? Une FMA met 4 cycles à donner son résultat, et le coeur peut en commencer deux par cycle. Il faut donc au moins huit calculs indépendants en cours pour qu'il ne s'arrête jamais. Avec un seul accumulateur, chaque FMA attendrait la précédente : on mesurerait la latence, pas le débit.
La fréquence se mesure à part, par une chaîne d'additions entières dépendantes : une par cycle, donc autant d'additions par seconde que de cycles. Sur un coeur seul, 5,31 GHz. Quand les 8 coeurs calculent, le noyau en relève 5,15.
| Jeu d'instructions | 1 thread | 8 threads | 16 threads | Opérations par cycle et par coeur |
|---|---|---|---|---|
| AVX2, FMA sur 256 bits | 164 | 1 314 | 1 315 | 31,9 |
| AVX-512, FMA sur 512 bits | 164 | 1 314 | 1 315 | 31,9 |
vdpbf16ps, paires de bf16 | 328 | 2 628 | 2 631 | 63,8 |
vpdpbusd, octets | 656 | 5 258 | 5 259 | 127,6 |
En milliards d'opérations par seconde (Gop/s). Deux unités FMA de 256 bits, huit f32
chacune, deux opérations par FMA : 32 opérations par cycle. À 5,15 GHz sur 8 coeurs, le
maximum théorique est de 1 318 Gop/s. La boucle en tire 1 314, soit 99,7 % : la
mesure est juste, et c'est le plafond de tout ce qui suit.
Trois choses se lisent dans ce tableau.
- L'AVX-512 ne calcule pas plus vite que l'AVX2. Une FMA de 512 bits occupe les deux unités à la fois. Son intérêt est ailleurs : deux fois moins d'instructions à décoder, et deux fois plus de registres.
- Le SMT n'ajoute rien. Deux threads sur un même coeur se partagent ses deux unités FMA. Seize threads font le même travail que huit.
- Les petits formats vont plus vite. Les paires de
bf16doublent le débit, les octets le quadruplent. Ce sera utile pour entraîner en précision mixte (article 3) et pour générer avec des poids quantifiés (article 4).
La mémoire, en trois marches
Calculer ne suffit pas : il faut lire ce qu'on calcule. Le programme de référence pour
mesurer la bande passante est STREAM
(McCalpin). Ses deux noyaux les plus simples sont la
copie, a[i] = b[i], et la triad, a[i] = b[i] + s × c[i]. On les répète sur des
tableaux de plus en plus grands, et l'on compte les octets à la façon de STREAM : deux
tableaux par élément pour la copie, trois pour la triad.
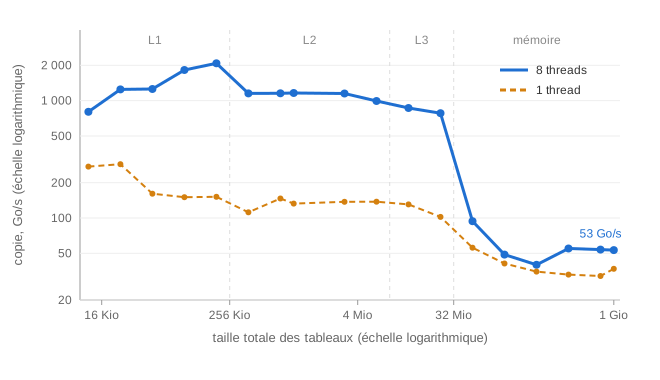
Avec 8 threads, chacun sur ses propres tableaux, la courbe descend par paliers, et chaque palier est un niveau de cache :
| Taille totale | Où sont les données | Copie |
|---|---|---|
| jusqu'à 192 Kio | L1, 32 Ko par cœur | ~2 To/s |
| jusqu'à 3 Mio | L2, 1 Mo par cœur | ~1,2 To/s |
| jusqu'à 24 Mio | L3, 32 Mo partagés | 0,8 à 1,1 To/s |
| au-delà | la mémoire | 53 Go/s |
La dernière marche est la plus haute : quinze à vingt fois moins que le L3. Et un thread seul lit déjà la mémoire à 50 Go/s. Au-delà du L3, ce ne sont pas les coeurs qui manquent, c'est la mémoire qui borne.
Le roofline du processeur
La série inférence a dessiné le modèle « roofline » de la carte (Williams, Waterman et Patterson, 2009) : la performance possible est le minimum de deux droites, celle de la mémoire, qui monte avec le nombre d'opérations faites par octet lu, et celle du calcul, plate. Les deux se croisent au point d'équilibre : le nombre d'opérations par octet où la mémoire cesse de limiter et où le calcul prend le relais.
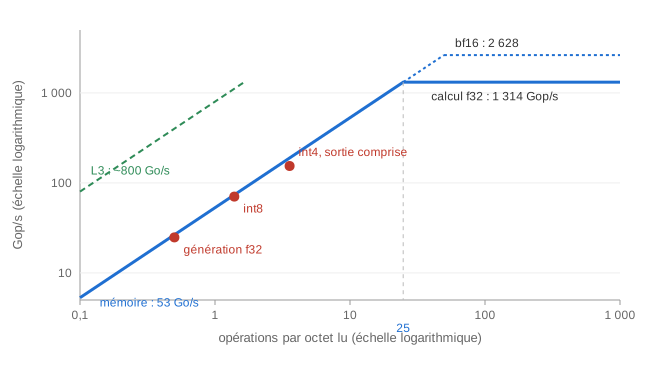
Le point d'équilibre de la mémoire est à 1 314 / 53 = 25 opérations par octet. Celui de la carte était à 38. Un calcul qui fait moins de 25 opérations par octet lu en mémoire attend la mémoire. Au-dessus, il attend le calcul. Pour des données qui tiennent dans le L3, le point d'équilibre tombe vers 1,6 : presque tout y devient limité par le calcul.
Les deux usages de cette série tombent de part et d'autre :
- La génération lit chaque poids une fois pour une multiplication-addition : 0,5
opération par octet en
f32, tout au fond de la pente. Les 29,4 millions de poids du modèle font 118 Mo. A 53 Go/s, il faut 2,2 ms, soit 450 tokens par seconde au mieux. - L'entraînement multiplie des matrices de milliers de lignes : chaque poids lu sert des milliers de fois. Il est limité par le calcul, et sa borne est le plafond de 1 314 Gop/s.
Le point de départ
Le backend de référence, mesuré sur les mêmes tâches :
| Mesure | Cpu<f32> | Part du maximum |
|---|---|---|
Produit 1024 × 1024 × 1024 | 0,65 Gop/s | 0,05 % |
Pas small, lot de 32 × 64 | 4,66 s, 439 tokens/s | |
Pas xl, lot de 1 × 512 | 112 s, 5 tokens/s | 0,07 % |
| Génération | 16 tokens/s | 3,6 % de la borne |
Deux mille fois sous le maximum de calcul. La raison tient dans trois lignes :
for i in 0..rows
La boucle intérieure descend une colonne de b : d'un élément au suivant, il y a toute une
ligne, 4 Ko pour une matrice de 1 024 colonnes. Chaque élément est dans une autre ligne de
cache.
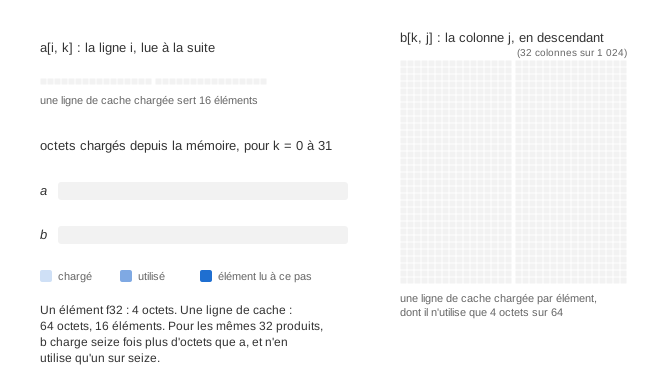
Rien ne se vectorise, et toutes les additions s'enchaînent sur une seule somme, à 3 cycles chacune. C'est exactement ce qu'il faut pour une implémentation de référence : le calcul se lit sans effort. Mais c'est le contraire de ce que l'on veut pour de bonnes performances.
Le profileur, sans la carte
Où part le temps d'un pas ? La première série a un profileur qui chronomètre chaque opération, mais il est écrit pour la carte : il attend le GPU après chaque kernel, parce qu'une horloge autour d'un lancement ne mesure que sa mise en file.
Sur le processeur, une opération est finie quand l'appel rend la main. Le même profileur, générique, se réduit à une horloge autour de chaque appel :
Il enveloppe n'importe quel backend, et donne, pour le pas small du backend de
référence :
| Opération | Part du temps |
|---|---|
affine (gradient) | 52,1 % |
affine | 27,2 % |
attention (gradient) | 6,1 % |
normalize (gradient) | 2,9 % |
| le reste | 11,7 % |
Les couches linéaires et leurs gradients font 79 % du temps, et sur le pas xl, les
produits en font 92 %. Le premier chantier est donc tout trouvé : le produit matriciel.
Ce qu'il faut retenir
- Le maximum se mesure avant d'optimiser : 32 opérations par cycle et par coeur, 1,31 téraopération par seconde sur 8 coeurs, à 99,7 % de la théorie.
- L'AVX-512 de Zen 4 ne calcule pas plus vite que l'AVX2, le SMT n'ajoute rien, les
paires de
bf16doublent le débit, les octets le quadruplent. - La mémoire descend en trois marches. La dernière, 53 Go/s, est la plus haute : le point d'équilibre du roofline est à 25 opérations par octet.
- La génération est tout en bas de la pente : 450 tokens par seconde au mieux en
f32. L'entraînement est sous le plafond du calcul. - Le backend de référence est deux mille fois sous ce plafond, et passe 80 à 90 % de son temps dans les produits matriciels.
La suite optimise ces produits sur le processeur : Le produit matriciel.