Articles · Smallem : le processeur
Tout ce qui n'est pas un produit
Troisième article de la série Smallem : le processeur. Précédent : Le produit matriciel.
Le produit matriciel tourne à plus de 1 000 Gop/s. Mais un pas d'entraînement n'est pas
fait que de produits, et une fois ceux-ci rapides, le reste se voit. Le profil d'un pas du
modèle xl (GPT-2, AdamW, lots de 16 séquences de 512 tokens), à ce stade :
| Opération | ms par pas | Part |
|---|---|---|
affine (gradient) | 913 | 26 % |
attention (gradient) | 910 | 26 % |
affine | 420 | 12 % |
attention | 320 | 9 % |
| GELU et son gradient | 347 | 10 % |
matmul (la sortie) | 196 | 6 % |
| normalisations | 152 | 4 % |
| le reste | 230 | 7 % |
3 488 ms par pas. Les couches et la sortie tournent au rythme du produit, environ 950 Gop/s, et ne font plus que 44 % du temps. L'attention en fait 35 %. Cet article s'occupe de tout le reste, en commençant par ce qui sert à toutes les opérations : les threads, et la mémoire.
Des threads qui attendent
Une opération de nos modèles prend de quelques microsecondes à quelques millisecondes.
Créer un thread en coûte des dizaines : on ne peut pas en créer à chaque opération. Le groupe
de threads de Fast les crée une fois, un par coeur, et ils attendent du travail.
Un appel confie tasks tâches numérotées au groupe, et attend qu'elles soient toutes
faites. Chaque thread prend la suivante dans un compteur commun, et le thread appelant travaille
avec eux :
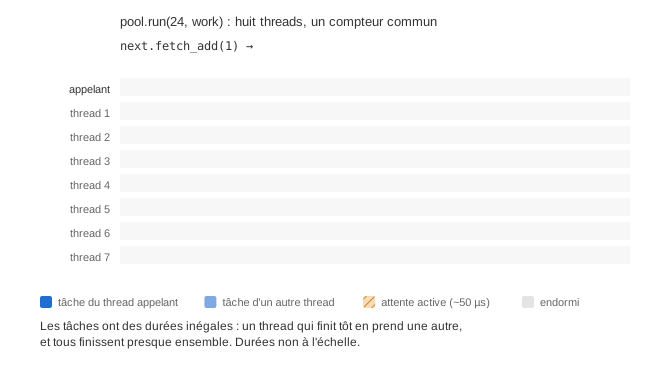
Entre deux opérations, un thread inoccupé attend activement, en relisant un compteur, pendant une cinquantaine de microsecondes, puis s'endort. Un appel vide coûte ainsi 0,96 µs avec 8 threads, réveiller des threads endormis, 6 à 20 µs.
Combien de threads ? On l'a vu, le SMT n'ajoute aucun calcul. Il n'ajoute rien non plus au
produit (1 064 Gop/s à 16 threads, 1 071 à 8), ni à un pas du modèle small (26,3 ms contre
25,0), et seize threads qui attendent activement se gênent : l'appel vide passe à 7,5 µs.
Fast prend donc un thread par coeur physique, lu dans /proc/cpuinfo.
À partir de quelle taille partager ? Sur une addition de deux tenseurs, un thread seul fait 32 000 éléments en 2,4 µs, et huit threads en 2,5 : c'est la frontière. À 64 000, huit threads vont deux fois plus vite. Une tâche fait donc au moins 16 384 éléments, et une petite opération reste sur le thread appelant.
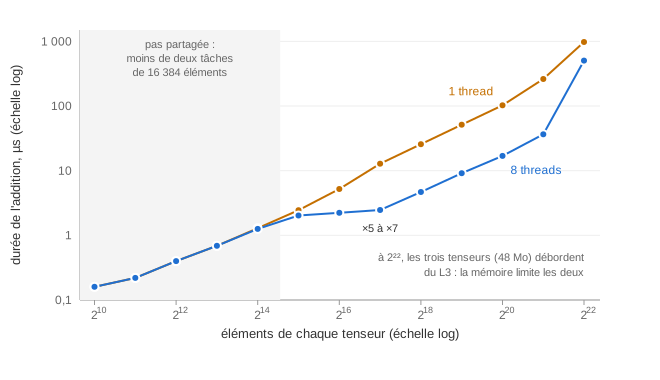
Avec cette règle, les deux courbes se confondent jusqu'à 16 384 éléments. À 32 768, deux tâches gagnent déjà un peu, 2,0 µs au lieu de 2,45. Au-delà, huit threads vont cinq à sept fois plus vite. À 4 millions d'éléments, les trois tenseurs, 48 Mo, débordent du L3 : la mémoire limite alors les deux, et huit threads ne font plus que deux fois mieux qu'un.
Le même résultat, quel que soit le nombre de threads. Le découpage en tâches dépend de la forme du tenseur, jamais du nombre de threads. Une somme sur un long axe, comme le gradient d'un biais sur 8 192 lignes, se coupe en paquets fixes de 256 lignes, dont les sommes partielles s'additionnent ensuite dans l'ordre. Les tests exécutent chaque primitive et chaque opération avec un, deux et huit threads, et comparent les bits.
Une page à la fois
En mesurant le pas du modèle small sur un et huit threads, un chiffre ne collait pas :
huit threads n'allaient que quatre fois plus vite, et les opérations limitées par la mémoire
encore moins. Le compteur du système a donné la raison : 34 000 défauts de page par
pas.
Chaque opération rend un nouveau tenseur, donc un nouveau tampon. Un gros tampon vient du système, et le système ne donne pas la mémoire tout de suite : il la donne page par page, à la première écriture, en interrompant le programme et en mettant chaque page de 4 Ko à zéro. Puis, quand le tenseur est abandonné, le tampon retourne au système, et tout recommence au pas suivant. Un tiers du pas passait à cela.
Le remède est celui du backend de la carte : une réserve de tampons. Un tampon
abandonné retourne dans la réserve, rangée par taille exacte, et la demande suivante de la
même taille le reprend. Les formes d'un pas se répètent d'un pas à l'autre : après le
premier, presque tout vient de la réserve. Le pas small passe de 58 à 41 ms.
L'exponentielle
Le softmax, GELU, SiLU et la perte demandent une exponentielle par élément. Celle de la
bibliothèque mathématique est exacte, mais elle ne se vectorise pas. Celle de Fast suit
l'algorithme de Cephes : on écrit x = n·ln 2 + r, avec n entier et |r| ≤ ln 2 / 2
alors exp(x) = 2ⁿ · exp(r). 2ⁿ se construit directement dans l'exposant du f32, et
exp(r) est un polynôme de degré 7 sur un petit intervalle.
let n = .round_ties_even;
let r = fma;
let r = fma;
let mut p = 1.987_569_1e-4;
p = fma;
// … quatre coefficients de plus
let y = fma + 1.0;
let value = y * f32from_bits;
fma(a, b, c) calcule a × b + c en une seule instruction et un seul arrondi, sauf dans
la version compilée pour un processeur qui n'a pas la FMA, où elle devient une
multiplication et une addition. Quand le processeur a la FMA, elle sert deux fois : la
soustraction de n·ln 2 ne perd rien à un arrondi intermédiaire, et chaque étape du
polynôme tient en une instruction.
ln 2 est coupé en deux constantes, pour que n·ln 2 reste exact. Le résultat est à deux
ulps près sur tout l'intervalle utile, et vaut 0 et l'infini aux deux bouts, ce que vérifie
un test.
Ce code n'a rien de vectoriel : ce sont des opérations sur un f32. Il est appliqué à des
paquets de seize éléments, dans une fonction compilée trois fois, une par jeu
d'instructions, que choisit le processeur à l'exécution :
multiversion!
La macro écrit une version avec #[target_feature(enable = "avx512f,…")], une avec AVX2,
et une sans. Dans chacune, le compilateur vectorise la boucle avec les registres qu'il a.
Une passe par ligne
Les opérations de nos modèles sont définies par les primitives : une normalisation est une
moyenne, une soustraction, une variance, une racine, une division. Chaque primitive écrit
son résultat en mémoire, et la suivante le relit. Le backend de la carte avait des kernels
dédiés pour chacune. Fast a maintenant une écriture directe de chaque opération, le plus
souvent en une passe par ligne : la ligne tient dans le L1, on y calcule moyenne et variance,
puis la sortie, sans tenseur intermédiaire.
| Opération | Avant | Après |
|---|---|---|
| GELU et son gradient | 345 ms | 69 ms |
| normalisations et leurs gradients | 148 ms | 35 ms |
GELU gagne surtout par l'exponentielle : sa tangente hyperbolique s'écrit
1 - 2 / (exp(2u) + 1). Chaque écriture directe est comparée, dans les tests, à la
définition de référence en f64.
L'attention en tuiles
Écrite avec les primitives, l'attention range la matrice des scores [lot, têtes, T, T],
puis celle des poids, et les relit dans la passe arrière. Pour le modèle xl, ce sont 128
matrices de 512 × 512 : 128 Mo par tenseur, quatre fois le L3. C'est le mur que la première
série avait trouvé sur la carte, et le remède est le même : FlashAttention
(Dao et al., 2022).
Chaque tâche prend une tuile de 128 requêtes d'une tête, et parcourt les clés par blocs de 128. La tuile de scores, 64 Ko, reste dans le L2 et n'est jamais écrite en mémoire. Le softmax se fait en ligne : à chaque bloc, le maximum de la ligne peut monter, et ce qui a déjà été accumulé est corrigé d'autant :
let new_max = max.max;
let correction = .exp;
let total = exp_shifted_sum;
sum = sum * correction + total;
scale;
Les blocs entièrement dans le futur de la tuile ne sont pas calculés : la moitié du travail
à l'entraînement. La passe avant garde L = m + ln(l) par requête, et la passe arrière
recalcule les poids, p = exp(s - L), tuile par tuile. Les produits de chaque tuile passent
par le produit par blocs, sur le thread de la tâche.
| Tuiles | Attention et gradient, ms par pas |
|---|---|
| primitives | 1 230 |
| 32 × 128 | 342 |
| 64 × 128 | 286 |
| 64 × 256 | 343 |
| 128 × 128 | 265 |
Ce qui reste
Le pas xl passe de 3 488 à 2 148 ms : 3 813 tokens par seconde, 768 Gop/s d'opérations
utiles, 58 % du maximum. Les produits des couches et de la sortie en font 72 %, avec ceux de
l'attention, 84 %. Le but était 75 % sans l'attention : il n'est pas tout à fait atteint.
Ce qui reste, 340 ms, n'est pas du calcul : additions des résidus et des gradients, transpositions qui séparent les têtes, gains des normalisations, perte. Ce sont des opérations limitées par la mémoire, que le modèle écrit avec les primitives, et qu'on ne fusionnerait qu'en changeant les couches elles-mêmes, pour tous les backends.
Entraîner sur le processeur
train --cpu entraîne maintenant avec Fast. Le tableau de l'article 1 des lois
d'échelle mesurait le rendement de la carte. Le voici avec le processeur, dans les mêmes
conditions (architecture moderne, vocabulaire de 8 192, lots de 16 × 512, Muon) :
| Modèle | Carte, tokens/s | Carte, rendement | Processeur, tokens/s | Processeur, rendement |
|---|---|---|---|---|
small (1,85 M) | 331 600 | 6,6 % | 32 695 | 35,3 % |
large (13,8 M) | 93 100 | 12,7 % | 6 252 | 46,0 % |
xl (29,4 M) | 49 800 | 14,1 % | 3 006 | 46,1 % |
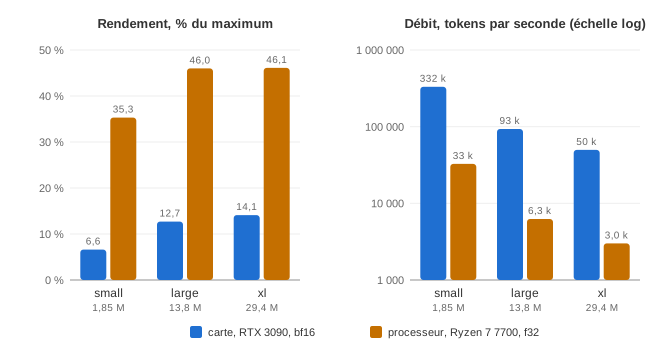
Le rendement se rapporte au maximum de chacun : 1 314 Gop/s en f32 pour le processeur, 71
Top/s en bf16 pour la carte. Le processeur tire trois fois mieux parti de son
maximum, mais ce maximum est cinquante fois plus petit : la carte va dix à dix-sept fois
plus vite.
Les deux calculent-ils la même chose ? Six cents pas du modèle small, même graine, sur le
processeur et sur la carte :
              carte                    processeur
pas    100  train 3.9619  val 2.8113   train 3.9619  val 2.8113
pas    300  train 2.5135  val 2.4327   train 2.5135  val 2.4327
pas    600  train 2.2178  val 2.1860   train 2.2178  val 2.1860
Identiques à quatre décimales, bien que les deux backends n'additionnent pas dans le même ordre.
À quoi sert alors le processeur ? Aux essais, d'abord : un pas du modèle small passe de
4,66 s avec le backend de référence à 25 ms. La suite de tests, elle, ne change pas (1,4 s) :
elle vérifie tout sur la référence en f64.
Et peut-être comme troisième place d'entraînement. Deux entraînements xl sur la carte font
20 000 tokens par seconde chacun. Un troisième sur le processeur ralentit la carte d'environ
1 %, parce que ses programmes ont eux aussi besoin du processeur pour préparer les lots et
lancer les kernels, et fait 2 600 tokens par seconde. La somme gagne 5,5 %. C'est peu, mais
c'est gratuit.
La précision mixte
Le premier article a mesuré vdpbf16ps : deux fois le débit du f32. Cette instruction
multiplie des paires de bf16 et ajoute leurs deux produits à un f32, comme les Tensor
Cores de la carte en précision mixte. Un second micro-kernel 14 × 32 s'en sert. Les
opérandes sont recopiés par paires d'indices communs, arrondis au bf16 le plus proche au
passage, et chaque instruction fait 32 multiplications-additions au lieu de 16.
Les règles sont celles de la précision mixte de la première série : seuls les grands
produits sont arrondis, les produits de quelques lignes et tout le reste du pas restent en
f32, et les poids aussi.
f32 | bf16 | |
|---|---|---|
Produits d'un pas xl | 927 à 1 148 Gop/s | 1 289 à 2 085 Gop/s |
Pas xl, moderne, Muon | 3 006 tokens/s | 3 897 tokens/s |
Modèle small | 73 500 tokens/s | 87 900 tokens/s |
Perte de validation, 600 pas de small | 2,2010 | 2,2007 |
Les produits vont jusqu'à 79 % du maximum bf16, et le pas xl gagne 30 % : le reste du
pas ne va pas plus vite. La perte reste celle du f32, et celle de la carte en précision
mixte (2,2009). Sur 200 pas du modèle xl, les trois courbes
se confondent : validation 5,7993 au dernier pas, en bf16, en f32 et sur la carte.
Ce qu'il faut retenir
- Des threads permanents qui attendent activement : un appel coûte une microseconde. Un thread par coeur ; le SMT n'aide pas.
- Le découpage du travail dépend des formes, jamais du nombre de threads : les résultats sont les mêmes au bit près.
- Un tampon neuf coûte ses défauts de page. Une réserve par taille exacte a rendu un tiers du
pas du modèle
small. - Une exponentielle de Cephes, écrite en Rust ordinaire et compilée trois fois, rend GELU cinq fois plus rapide.
- L'attention en tuiles et en ligne, comme sur la carte : de 1 230 à 265 ms par pas.
- Le processeur tire 46 % de son maximum sur un pas
xl, la carte 14 % du sien, mais la carte va seize fois plus vite. Les deux donnent les mêmes pertes. - En
bf16, le produit double presque, et le pas gagne 30 %.
Reste ce que le processeur fait le mieux : Générer sans la carte.