Articles · Smallem : le processeur
Le produit matriciel
Deuxième article de la série Smallem : le processeur. Précédent : Ce que vaut un processeur.
Le processeur peut faire 1 314 milliards d'opérations par seconde, et le produit en triple
boucle du backend de référence en effectue 0,65. Cet article comble l'écart sur le produit
1024 × 1024 × 1024 :
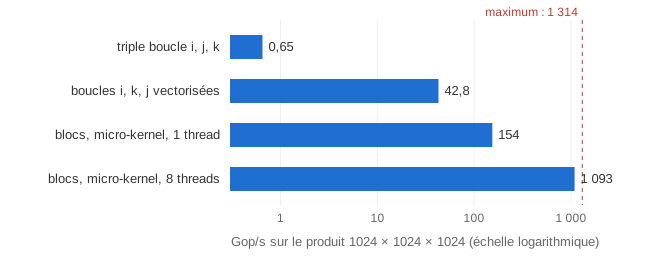
Trois idées font l'essentiel : changer l'ordre des boucles, découper le produit en blocs qui tiennent dans les caches, et le calculer avec un petit noyau qui ne sort jamais des registres. La méthode est celle de Goto et van de Geijn (2008), reprise par la bibliothèque BLIS (Van Zee et van de Geijn, 2015).
L'ordre des boucles
La triple boucle i, j, k descend une colonne de B dans sa boucle intérieure. Il suffit
d'échanger les deux dernières boucles pour qu'elle parcoure des lignes :
for i in 0..N
La boucle intérieure ajoute x fois une ligne de B à une ligne de C. Chaque mul_add
est une FMA, une multiplication-addition fusionnée : a × b + c en une seule instruction.
Les deux lignes sont contiguës : le compilateur la vectorise, seize f32 par instruction, et
il n'y a plus de somme unique dont chaque addition attend la précédente. On passe de 0,65 à 42,8 Gop/s,
soixante-cinq fois plus, sur un seul coeur.
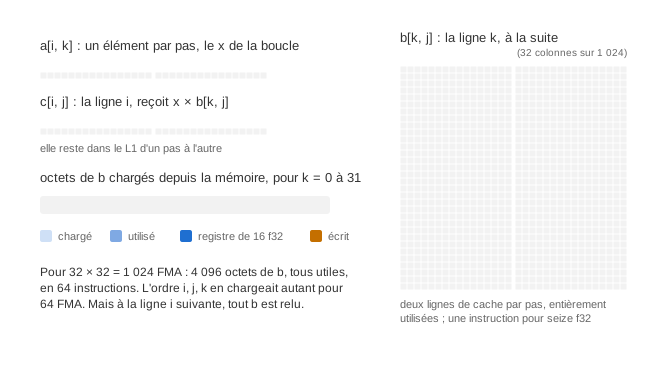
C'est encore le quart de ce que fait un coeur. Pour chaque ligne i, la boucle relit B
en entier : 4 Mo, qui ne tiennent pas dans le L2. Chaque FMA attend une donnée qui vient du
L3.
Des blocs qui tiennent dans les caches
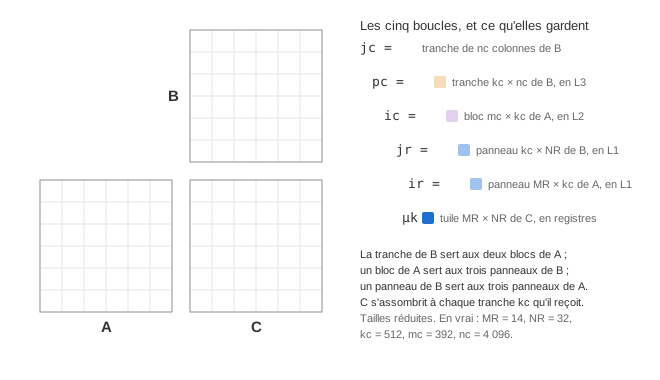
Le produit par blocs découpe le calcul pour que chaque niveau de cache garde ce qu'il relit :
pour chaque tranche de nc colonnes de B         (jc)
  pour chaque tranche de kc indices communs     (pc)  B[pc, jc] recopié, en L3
    pour chaque bloc de mc lignes de A          (ic)  A[ic, pc] recopié, en L2
      pour chaque panneau de NR colonnes        (jr)  un panneau de B, en L1
        pour chaque panneau de MR lignes        (ir)
          micro-kernel : C[MR × NR] += A[MR × kc] · B[kc × NR]
La tranche de B est découpée en panneaux de NR colonnes, et le bloc de A en panneaux
de MR lignes. Le micro-kernel croise un panneau de chacun pour calculer une tuile de C.
Lu de l'intérieur vers l'extérieur : le micro-kernel calcule une petite tuile de C sur
toute une tranche kc de la dimension commune. Il relit le même panneau de B pour tous
les panneaux de lignes d'un bloc de A : ce panneau reste près du coeur. Le bloc de A
sert à tous les panneaux de B de la tranche : il reste dans le L2. Et la tranche de B
sert à tous les blocs de A : elle reste dans le L3, partagée entre les coeurs.
Le micro-kernel
Tout le calcul passe par le micro-kernel, et il doit approcher les 32 opérations par
cycle mesurées dans l'article précédent. Sa tuile de C ne quitte jamais les registres :
avec trente-deux registres AVX-512, on garde une tuile de 14 lignes sur 32 colonnes, soit
vingt-huit accumulateurs de seize f32, et il reste de la place pour deux registres de
B et un élément de A.
let mut acc = ;
for _ in 0..kc
À chaque indice de la tranche : deux lectures de B, quatorze éléments de A diffusés,
vingt-huit FMA. C n'est lu et écrit qu'une fois, à la fin. Seul, sur des données qui
tiennent dans le L1, il fait 162,5 Gop/s, presque tout ce que peut un coeur.
En AVX2, il n'y a que seize registres : la tuile est de 6 × 16, douze accumulateurs. Il
fait 167,9 Gop/s, autant. L'AVX-512 ne calcule pas plus vite par cycle sur Zen 4, on l'a
vu ; il charge seulement deux fois moins de A et de B par FMA. Les deux noyaux sont
gardés, et choisis à l'exécution selon ce que sait le processeur, avec un troisième sans
instructions vectorielles explicites pour les autres.
Packing
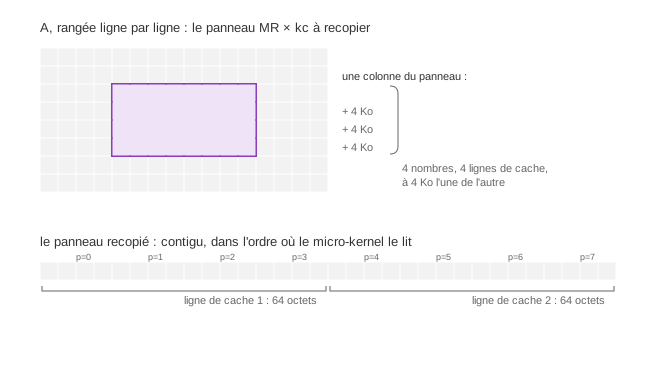
Le micro-kernel lit A et B dans un ordre précis : pour chaque indice de la tranche, les
14 éléments d'une colonne de A, puis les 32 d'une ligne de B. Dans les matrices
d'origine, ils sont éparpillés : les 14 éléments d'une colonne de A sont sur 14 lignes
différentes, à 4 Ko l'un de l'autre pour une matrice de 1 024 colonnes, et les lignes
successives d'un panneau de B aussi. On les recopie donc, avant le calcul, dans cet ordre
exact : c'est le packing.
La recopie coûte peu, une lecture et une écriture par élément pour des centaines de FMA, et elle règle trois problèmes d'un coup :
- Les bords. Une matrice dont le nombre de lignes n'est pas un multiple de 14, la hauteur de la tuile, ou dont le nombre de colonnes n'est pas un multiple de 32, sa largeur, est complétée par des zéros. Le micro-kernel calcule toujours une tuile entière, et n'écrit que la partie utile.
- Les transposées. Une matrice se lit avec deux pas, celui des lignes et celui des colonnes, une transposée n'est qu'un échange des pas. Le packing lit n'importe quels pas, et le micro-kernel ne voit jamais que des panneaux contigus.
- Le lot. Une couche linéaire multiplie
[lot, positions, C]par une même matrice[C, N]: toutes les lignes du lot forment une seule grande matrice, recopiée une fois.
Les transposées comptent pour l'entraînement. La rétropropagation d'une couche affine
calcule g · Wᵀ et xᵀ · g : le backend de référence recopiait W et x transposées à
chaque pas. L'opération Affine de Fast passe les mêmes tenseurs, avec leurs pas
échangés, au produit par blocs.
Les tailles de blocs
Restent kc, mc et nc. Low et al.
(2016) montrent qu'on peut les tirer des
caractéristiques des caches au lieu de les chercher : le panneau kc × NR de B doit
tenir dans une part du L1, le bloc mc × kc de A dans une part du L2. Pour 32 Ko de L1 et
un panneau de 32 colonnes, cela donne kc autour de 192.
Un balayage dit autre chose, en Gop/s sur 8 threads :
kc | mc | 1024³ | 8192 × 512 × 1536 | 8192 × 2048 × 512 |
|---|---|---|---|---|
| 128 | 392 | 970 | 910 | 968 |
| 256 | 392 | 1 045 | 1 046 | 975 |
| 512 | 392 | 1 082 | 1 137 | 1 036 |
| 1 024 | 392 | 1 076 | 1 132 | 1 073 |
Plus la tranche est longue, mieux c'est, jusqu'à 512. Au-delà, plus rien de net. Le
panneau de B déborde alors du L1, mais le L2 de Zen 4 le livre assez vite au micro-kernel, qui ne demande que 128 octets
de B pour vingt-huit FMA. Une tranche plus longue relit C moins souvent. Le modèle
analytique n'est pas faux, mais il suppose que le L1 seul nourrit le noyau : ici, la
mesure l'emporte. Retenus : kc = 512, mc = 392, nc = 4096.
kc a une autre importance : c'est la seule taille qui change le résultat. Un élément de
C est la somme de ses termes tranche après tranche. Changer kc change l'ordre des
additions, et donc les derniers bits.
Huit threads
Il y a deux façons de partager le produit entre les coeurs. Chaque thread peut prendre des
blocs de lignes de A et de C, et lire la même tranche recopiée de B, partagée dans le
L3. Ou prendre un groupe de colonnes de B et de C, qui reste dans son propre L2, en
recopiant lui-même chaque bloc de A.
Le partage par lignes tient en deux appels au groupe de threads, pour chaque tranche de
B :
for pc in .step_by
| Partage | 1024³ | 8192 × 512 × 1536 | 8192 × 2048 × 512 |
|---|---|---|---|
| par lignes | 1 067 | 1 145 | 1 026 |
| par colonnes | 806 | 782 | 619 |
Les lignes l'emportent de 25 à 40 %. Partager les colonnes oblige chaque thread à recopier
tout A : le même travail est fait huit fois. Quand il y a trop peu de lignes pour occuper
les threads, comme pour dW = xᵀ · g dont A n'a que 512 lignes, on partage aussi les
colonnes.
Les threads prennent leurs tâches dans un compteur commun, et il y a au moins trois tâches par
thread : un thread qui finit tôt en prend une autre, et tous finissent ensemble. Ce partage ne
change aucun calcul. Chaque élément de C est toujours la somme de ses termes, tranche
après tranche, dans le même ordre : avec un, deux ou huit threads, le résultat est le même au
bit près, et les tests le vérifient.
Nos produits
Le produit carré 1024³ n'est qu'un banc d'essai. Ceux que Smallem calcule ont d'autres
formes : longues et étroites dans un pas d'entraînement du modèle xl, petites dans Muon.
Les voici, mesurés un par un :
| Produit | Forme | Gop/s | Part du maximum |
|---|---|---|---|
| carré | 1024³ | 1 071 | 82 % |
xl, requêtes, clés, valeurs | 8192 × 512 × 1536 | 1 138 | 87 % |
xl, MLP, montée | 8192 × 512 × 2048 | 1 137 | 87 % |
xl, MLP, descente | 8192 × 2048 × 512 | 1 039 | 79 % |
xl, sortie x · Eᵀ | 8192 × 512 × 8192 | 1 145 | 87 % |
xl, dW = xᵀ · g | 512 × 8192 × 2048 | 943 | 72 % |
xl, dx = g · Wᵀ | 8192 × 2048 × 512 | 1 045 | 80 % |
Muon, X · Xᵀ | 512 × 2048 × 512 | 949 | 72 % |
Entre 72 et 87 % du maximum. Le reste est perdu au packing, aux bords, et à la synchronisation des threads entre deux tranches.
Quelques lignes
En génération, A n'a qu'une ligne, celle du token qu'on produit, ou quelques-unes quand
on génère par lots. Le packing de B coûterait alors plus cher que le produit lui-même : chaque
poids ne sert qu'une fois par ligne de A.
Un second noyau traite ce cas sans packing. Il garde dans les registres une tuile de 4
lignes sur 64 colonnes de C, ou d'une ligne sur 256 : seize registres. À chaque indice de
la dimension commune, il lit 64 poids consécutifs d'une ligne de B, et les multiplie par
les 4 éléments de A. Chaque ligne de B est lue une fois pour toutes les lignes de A.
La première version était écrite en Rust ordinaire, avec des tableaux de taille fixe, en comptant sur le compilateur pour les garder dans les registres :
let mut acc = ; // 4 lignes × 64 colonnes de C
for p in 0..k
Il ne l'a pas fait. Le code machine montre chaque accumulateur réécrit sur la pile après sa FMA :
vfmadd231ps (%rax),%zmm0,%zmm5
vfmadd231ps 0x40(%rax),%zmm0,%zmm6
vmovups %zmm5,0x1a0(%rsp)
vmovups %zmm6,0x1e0(%rsp)
La version suivante dit explicitement ce qui va dans les registres, avec les intrinsèques
AVX-512, comme le micro-kernel : seize accumulateurs de seize f32, quatre éléments de A
diffusés, et un registre pour les poids.
let mut acc = ; // 4 lignes × 4 registres de 16 colonnes
for p in 0..k
Le noyau passe de 287 à 789 Gop/s sur 8 lignes, et de 444 à 1 110 sur 16. Il bat alors le produit par blocs bien au-delà de ce qu'on attendait :
Lignes de A | Sans packing | Par blocs |
|---|---|---|
| 1 | 205 | 37 |
| 8 | 794 | 285 |
| 32 | 1 155 | 631 |
| 128 | 1 196 | 960 |
| 256 | 1 202 | 1 071 |
Sur [m, 512] · [512, 2048], en Gop/s. Avec une dimension commune de 512, une bande de B
de 64 colonnes tient dans le L2, et le noyau sans packing la relit à chaque groupe de
4 lignes sans attendre. La frontière est donc à 256 lignes face à une matrice rangée
ligne par ligne. Face à une transposée, où chaque élément devient un produit scalaire de
deux lignes, elle est à 16.
Il fallait encore occuper les threads. Une matrice 512 × 512 coupée en groupes de 256
colonnes ne fait que deux tâches : deux coeurs travaillent, six attendent. C'est le défaut
que la série inférence avait trouvé sur la carte, avec 8 blocs pour 82 multiprocesseurs, et
le remède est le même : couper aussi la dimension commune en tranches, chacune dans sa
somme partielle, additionnées ensuite dans l'ordre. Le nombre de tâches visé est fixe, 32,
et ne dépend pas du nombre de threads : le résultat non plus.
Ce qu'il faut retenir
- L'ordre des boucles vaut ×65 : une boucle intérieure contiguë se vectorise.
- Le produit par blocs garde chaque niveau de cache occupé par ce qu'il relit. Le micro-kernel ne quitte pas les registres et fait 99 % de ce que peut un coeur.
- Le packing règle les bords, les transposées et le lot. La rétropropagation lit ainsi ses opérandes transposés sans les recopier.
- Le modèle analytique des tailles de blocs suppose un L1 qui nourrit seul le noyau. Sur Zen 4, une tranche quatre fois plus longue gagne 5 à 10 %.
- Huit threads, des blocs de lignes et une tranche de
Bpartagée : 72 à 87 % du maximum sur nos produits, et le même résultat au bit près quel que soit le nombre de threads. - Pour quelques lignes, un noyau sans packing, écrit en intrinsèques : le compilateur n'avait pas gardé ses accumulateurs dans les registres.
Le produit est rapide. Le reste du pas ne l'est pas encore : Tout ce qui n'est pas un produit.