Articles · Smallem : le processeur
Générer sans la carte
Quatrième et dernier article de la série Smallem : le processeur. Précédent : Tout ce qui n'est pas un produit.
Générer un token lit chaque poids du modèle une fois, pour une seule
multiplication-addition. Le premier article en a tiré la borne : 118 Mo de poids f32, lus
à 53 Go/s, 2,2 ms par token, 450 tokens par seconde au mieux. La carte, avec sa mémoire
dix-huit fois plus rapide, en fait 989, loin de sa propre borne : la série inférence a
montré qu'elle attend surtout le lancement de ses kernels.
C'est donc là que le processeur est le moins loin de la carte. Peut-il la rattraper ?
Une ligne face à une matrice
Avec ce qu'ont construit les articles précédents, la génération fait 235 tokens par seconde. Le profil d'un token :
| Opération | µs par token | Part |
|---|---|---|
affine | 3 213 | 76 % |
cached_attention | 560 | 13 % |
transposed_matmul (la sortie) | 314 | 7 % |
La sortie lit sa table de 16,8 Mo en 314 µs : 53 Go/s, la vitesse de la mémoire. Les couches
affines, 101 Mo en 3,2 ms : 31 Go/s seulement. La raison est celle de la série inférence sur
la carte. Le noyau sans packing de l'article 2 donnait à chaque thread un groupe de 256
colonnes : une matrice 512 × 512 n'en a que deux. Deux coeurs travaillaient, six
attendaient. Couper aussi la dimension commune en tranches fixes, chacune dans sa somme
partielle, fait 32 tâches : 2,1 ms, 48 Go/s.
L'attention sur le cache passait encore par sa définition de référence, faite de primitives : rassembler les clés de chaque séquence, les étirer par tête, les transposer. Écrite directement, une tâche par requête et par tête qui lit ses positions dans les tables du cache, elle passe de 560 à 103 µs.
413 tokens par seconde 92 % de la borne
En f32, c'est fini : on attend la mémoire. Pour aller plus vite, il faut lire moins.
Des octets
La série inférence a quantifié les poids : des codes de 8 ou de 4 bits, et une échelle par groupe. Sur la carte, cela n'avait rien fait gagner, puisque la carte n'attendait pas la mémoire. Sur le processeur, si.
Les codes du projet sont rangés dans des f32, 24 bits par nombre : 1,33 octet par poids en
int8. Le processeur lit mieux de vrais octets. À la première utilisation d'une matrice,
Fast recopie donc ses codes dans un rangement natif, un octet par poids en int8, deux
codes par octet en int4, et le garde tant que la matrice existe. Le noyau ressemble à celui
de l'article 2 : une tuile de 64 colonnes dans les registres, et chaque ligne de codes
convertie en f32 dans les registres avant la FMA :
let bytes = _mm_maskz_loadu_epi8;
let weights = _mm512_cvtepi32_ps;
for r in 0..R
L'échelle du groupe s'applique une fois, à la fin du groupe. Le résultat est celui du produit par les poids déquantifiés, aux arrondis près, et les tests le comparent à la définition de référence.
int8 1 197 tokens par seconde
Près de trois fois le f32, et plus que la carte.
La table de sortie
Le plan de cette série supposait que les 29 millions de poids, en int8, feraient 29 Mo, et
tiendraient dans les 32 Mo du L3. C'était oublier que la quantification de la série
inférence laisse en f32 la table d'embedding, qui sert aussi à la sortie : 4,2 millions de
poids, 16,8 Mo. Le modèle int8 lit en fait 42 Mo par token, et sa borne est de 1 256 tokens
par seconde : nous en sommes à 95 %.
D'où une option nouvelle, Gpt::quantize_output : la table transposée Eᵀ, [C, V], est
quantifiée comme une matrice de poids, avec ses échelles le long de C, donc une échelle
par token du vocabulaire. La table de l'entrée devient la table déquantifiée : l'entrée et
la sortie lisent les mêmes poids.
| Format | Mo lus par token | Borne à 53 Go/s | Mesuré |
|---|---|---|---|
f32 | 117,8 | 450 | 421 |
| int8 | 42,2 | 1 256 | 1 197 |
| int8, sortie comprise | 29,6 | 1 790 | 1 374 |
| int4/64 | 31,0 | 1 710 | 1 957 |
| int4/64, sortie comprise | 16,5 | 3 210 | 2 619 |
Ces débits sont ceux d'une seule séquence. La borne suppose que tous les poids viennent de la mémoire, à 53 Go/s. Deux lignes s'en écartent. L'int4 seul la dépasse, 1 957 tokens par seconde au lieu de 1 710 : une partie de ses 31 Mo vient donc du L3. L'int8 avec sa sortie, 29,6 Mo, devrait tenir tout entier dans les 32 Mo du L3, et dépasser largement sa borne, il reste au contraire en dessous, à 77 %.
Le L3 se voit, à moitié
Pour en avoir le coeur net, un programme multiplie une ligne par une suite de matrices int8 d'un mégaoctet, parcourues l'une après l'autre comme les couches d'un modèle, et mesure le débit des codes selon leur nombre :
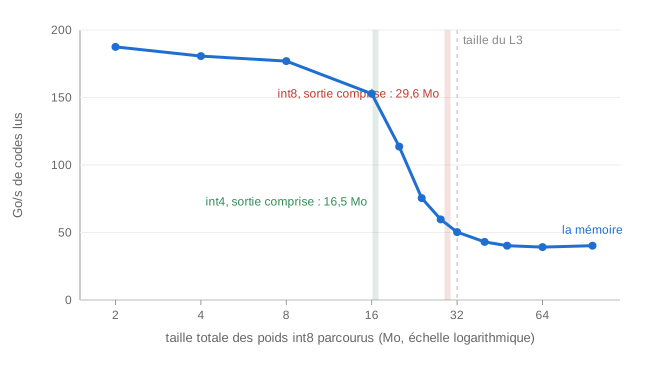
Le passage dans le L3 se voit, mais pas où on l'attendait. Le débit tient jusqu'à 8 Mo, la taille des huit L2 réunis, faiblit à 16, et s'effondre entre 20 et 32 Mo, bien avant la taille du L3. Le L3 de Zen 4 ne reçoit que ce que les L2 évincent, et un parcours en boucle d'un ensemble presque aussi grand que lui en chasse les lignes avant qu'elles ne resservent. Dans ce parcours, il ne garde utilement qu'environ la moitié de sa taille. L'int4 avec sa sortie, 16,5 Mo, est encore sur le plateau, l'int8 avec sa sortie, 29,6 Mo, déjà en bas.
Multiplier des octets
Sur le plateau, le noyau int8 lit ses codes à environ 200 Go/s, quand le même noyau en
f32 lit ses poids à plus de 400. Ce n'est plus la mémoire qui borne, c'est la conversion : trois instructions
pour seize poids, avant même la FMA.
Le premier article a mesuré l'instruction qui la supprime : vpdpbusd multiplie 64 octets
non signés par 64 octets signés et additionne les produits quatre par quatre dans seize
entiers de 32 bits, 128 opérations par cycle. Mais elle multiplie des octets par des
octets : il faut quantifier aussi les activations. Chaque ligne x l'est à son tour,
symétriquement, x ≈ s · q avec s = max |x| / 127, et rangée a = q + 128 pour être
positive. Le décalage se corrige ensuite, avec des sommes calculées une fois par colonne :
int8 : Σ q·w = Σ a·w − 128 Σ w
int4 : Σ q·w = Σ a·u − 8 Σ a − 128 Σ u + 1024 n      (u = w + 8, n lignes du groupe)
En int4, un octet porte deux codes : un masque et un décalage en redonnent deux registres, au rangement que demande l'instruction. Un test vérifie que, sur des activations déjà entières, le résultat est exactement celui des poids déquantifiés.
Ce n'est plus le même calcul : l'erreur des activations s'ajoute à celle des poids. Le mode
est donc explicite (Fast::with_int8_activations, --int8-activations).
| Format | Poids seuls | Activations en octets |
|---|---|---|
| int8, sortie comprise | 1 374 | 1 676 |
| int4/64, sortie comprise | 2 619 | 2 615 |
L'int8 gagne 22 %. L'int4 ne gagne rien, et la raison n'est plus le calcul. Un produit de la génération dure environ 4 µs, et il y en a 56 par token. Partager le travail entre les threads, attendre le dernier, additionner les sommes partielles, quantifier la ligne : ce coût fixe pèse autant que le calcul lui-même. Le processeur bute à son tour sur ce qui bornait la carte : le temps fixe de chaque opération.
Ce que coûte chaque format
Lire moins vite ne sert à rien si le modèle écrit moins bien. La perte se mesure ici par
le chemin même de la génération : 32 séquences de validation de 512 tokens, chaque token
passé à son tour par le cache, et l'on compte -ln p du token suivant.
| Format | Nats par token | Écart | Tokens par seconde |
|---|---|---|---|
f32 | 3,4674 | 421 | |
| int8 | 3,4677 | +0,0003 | 1 197 |
| int8, sortie comprise | 3,4680 | +0,0006 | 1 374 |
| int8, sortie comprise, activations en octets | 3,4689 | +0,0015 | 1 676 |
| int4/64 | 3,5000 | +0,0326 | 1 957 |
| int4/64, sortie comprise | 3,5201 | +0,0528 | 2 619 |
L'int8 ne coûte presque rien, même avec sa sortie et ses activations en octets : quatre
fois la vitesse du f32 pour 0,04 % de perte en plus. L'int4 coûte cent fois plus que
l'int8, comme sur la carte, et la sortie quantifiée en int4 aggrave encore l'écart de près
des deux tiers.
À plusieurs
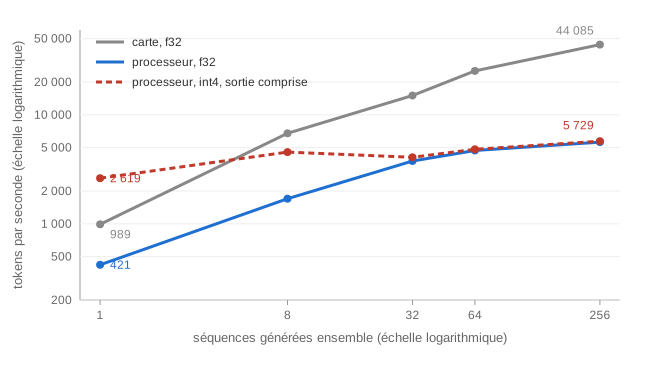
Générer plusieurs séquences à la fois réutilise chaque poids lu. Sur la carte, c'est ce qui faisait monter le débit jusqu'à 44 000 tokens par seconde. Sur le processeur :
| Séquences | 1 | 8 | 32 | 64 | 256 |
|---|---|---|---|---|---|
Carte, f32 | 989 | 6 774 | 15 029 | 25 292 | 44 085 |
Processeur, f32 | 421 | 1 700 | 3 772 | 4 709 | 5 625 |
| Processeur, int8, sortie comprise | 1 374 | 3 552 | 4 064 | 4 897 | 5 775 |
| Processeur, int4/64, sortie comprise | 2 619 | 4 547 | 4 073 | 4 824 | 5 729 |
Le processeur redevient limité par le calcul vers 16 à 32 séquences. Au-delà de 16 lignes, les produits passent par les poids déquantifiés, et tous les formats se rejoignent. La carte, elle, n'atteint sa borne de calcul que bien plus loin : 2,6 fois plus lente que le processeur sur une séquence, elle va près de huit fois plus vite à 256.
Le bilan
| Article | Mesure | Avant | Après |
|---|---|---|---|
| 1 | Maximum de calcul mesuré, f32 | 1 318 en théorie | 1 314 Gop/s |
| 2 | Produit 1024³ | 0,65 Gop/s | 1 071 Gop/s |
| 3 | Pas xl (GPT-2, AdamW) | 5 tokens/s | 3 813 tokens/s |
| 3 | Rendement d'un pas xl | 46 % (la carte : 14 %) | |
| 3 | Pas xl en bf16 | 3 006 tokens/s | 3 897 |
| 4 | Génération, une séquence | 16 tokens/s | 2 619 (la carte : 989) |
Trois leçons, qui ne sont pas propres au processeur.
La borne d'abord. Chaque étape a commencé par ce que la machine peut faire au mieux, et chaque fois la borne a dit où chercher : le calcul pour le produit, la mémoire pour la génération, et, à la fin, ni l'un ni l'autre, mais le coût fixe des appels. Une mesure qui dépasse la borne, comme l'int4 au-delà de la mémoire, est la meilleure des indications : une hypothèse est fausse quelque part.
Le compilateur ne garde pas tout dans les registres. Le même code, écrit en Rust ordinaire, vectorise très bien une exponentielle ou une normalisation. Mais un noyau dont tout l'intérêt est de garder un bloc dans les registres doit le dire explicitement.
Le processeur a sa place. Il ne remplace pas la carte pour entraîner ni pour servir beaucoup d'utilisateurs : seize fois plus lent à l'entraînement, huit fois à 256 séquences. Mais pour une personne qui génère seule, avec un modèle en int8, il va plus vite que la carte, sans elle, à 0,04 % de perte près. Et ce qu'il reste à faire est le même que sur la carte : fusionner davantage, pour que chaque token coûte moins d'appels.
Ce qu'il faut retenir
- En
f32, la génération atteint 92 % de sa borne mémoire, une fois chaque produit d'une ligne partagé entre tous les threads. - Des octets lus au lieu de
f32: trois fois plus vite en int8, et plus vite que la carte. - La table de sortie en
f32pesait 40 % des octets d'un modèle int8 : la quantifier coûte 0,0003 nats de plus. - Le L3 ne garde utilement qu'environ la moitié de sa taille dans un parcours en boucle : 16 Mo de poids en profitent, 30 Mo presque plus.
vpdpbusdsupprime la conversion des codes, au prix d'activations en octets : +22 % en int8. Au-delà, c'est le coût fixe de chaque appel qui borne.- Vers 16 à 32 séquences, le processeur redevient limité par le calcul, et la carte reprend l'avantage.