Apprendre à agir par essais et erreurs
Cinquième article de la série Smallem : un agent. Précédent : Enchaîner les actions.
Jusqu'ici, le modèle a appris en imitant des traces parfaites, écrites par le programme. Dans la série précédente, GRPO lui avait appris à trier mieux que l'imitation, en le laissant chercher seul et en récompensant ses réussites. Peut-on faire de même avec un agent, quand chaque réponse est un épisode entier, avec ses appels et les résultats des outils ?
L'idée n'est pas neuve : WebGPT (Nakano et al., 2021) apprenait à naviguer sur le web d'abord en imitant des humains, puis en optimisant une récompense. Nous suivons le même ordre : imiter d'abord, puis essayer.
GRPO dans la boucle
La méthode est celle de la série précédente. Pour chaque mission, le modèle joue un groupe de 8 épisodes, tirés à température 1. Chacun reçoit sa récompense, 1 si la réponse finale est juste, 0 sinon, et son avantage est sa récompense comparée à celle du groupe. Les épisodes meilleurs que leurs voisins deviennent plus probables. Un rapport borné et une laisse vers le modèle de départ empêchent de trop s'en éloigner.
Deux choses changent avec un agent.
Les épisodes se jouent dans la boucle. Les 128 épisodes d'un pas (16 missions, 8 épisodes chacune) avancent ensemble dans le même lot de génération. Chacun s'interrompt pour ses outils, à son rythme, pendant que les autres continuent. Les outils sont des fonctions pures : l'attente est nulle.
Le résultat d'un outil n'est jamais dans le gradient. Un épisode contient des tokens écrits par le modèle et d'autres écrits par le programme. Les seconds sont dans le contexte, mais pas dans le rapport des probabilités : on ne rend pas plus probable le résultat d'une addition, qui ne dépend pas du modèle. C'est le même masque qu'au fine-tuning : un booléen par token, vrai si le modèle l'a écrit.
<|utilisateur|> What is 4821 + 3907? <|assistant|>   programme  →  faux
<|appel|> add 4821 3907 <|resultat|>                 modèle     →  vrai
8728 <|assistant|>                                   programme  →  faux
8728 <|fin|>                                         modèle     →  vrai
Au fine-tuning, ce masque était écrit avec la trace idéale. Ici, personne ne l'écrit à
l'avance : la boucle le construit en jouant l'épisode. Elle note la longueur de la question,
et, à chaque reprise, les positions des tokens qu'elle a ajoutés, le résultat et
<|assistant|>. À la fin de l'épisode, tout est vrai sauf ces plages :
let mut written = vec!;
written.fill; // la question
for & in &entry.program
L'épisode passe alors à GRPO sous la même forme qu'un exemple de fine-tuning, des tokens et leur masque, et le reste du code d'entraînement n'a pas changé.
Sans réussite, rien à apprendre
Le premier essai visait le problème que l'imitation n'a pas résolu : les sommes de trois âges, à 5 et 6 appels, où le modèle oublie toujours le nom du milieu. Sur 20 pas, 2 560 épisodes tirés : aucune réponse juste. Pas une. Tous les épisodes d'un groupe ont la même récompense, nulle, donc tous les avantages sont nuls, et GRPO ne fait rien.
C'était la leçon du tri long dans la série précédente, et elle tient toujours : une méthode qui apprend de ses réussites ne peut rien sans réussites. Le tirage à température 1 ne suffit pas à faire apparaître un plan que le modèle n'envisage jamais.
Le second essai partait d'un modèle moins entraîné, pour qu'il ait des progrès à faire sur les missions de 3 et 4 appels : 500 pas de fine-tuning au lieu de 4 000. Raté aussi, mais autrement. Tiré à température 1, ce modèle encore incertain ne suit presque jamais le format :
What is the sum of the ages of Anna and Clara?
I need the age of Anna.dschrison birthlsSo released some 8,... would be from the age of …
Il écrit le début de sa phrase de pensée, puis repart dans le texte de FineWeb-Edu, et n'appelle rien. 0,06 appel par épisode, 5 300 épisodes sur 6 400 arrêtés par la longueur, récompense nulle. Le glouton choisit toujours le meilleur token et ne s'égare pas. Le tirage, lui, explore aussi les mauvais.
Quand le signal existe
Le troisième essai part d'un modèle entraîné 1 000 pas, sans phrase de pensée. Quand il prend à chaque pas le token le plus probable (génération gloutonne, celle de nos évaluations), il réussit déjà bien. Quand il tire chaque token au hasard selon ses probabilités, à température 1, comme pendant GRPO, il réussit beaucoup moins :
| Famille | Token le plus probable | Tirage, température 1 |
|---|---|---|
| 2 appels | 98,5 % | 57 % |
| 3 appels | 94 % | 28 % |
| 4 appels | 93,5 % | 23,5 % |
| somme à l'envers | 88,5 % | 39 % |
| deux plus grands | 84,5 % | 51 % |
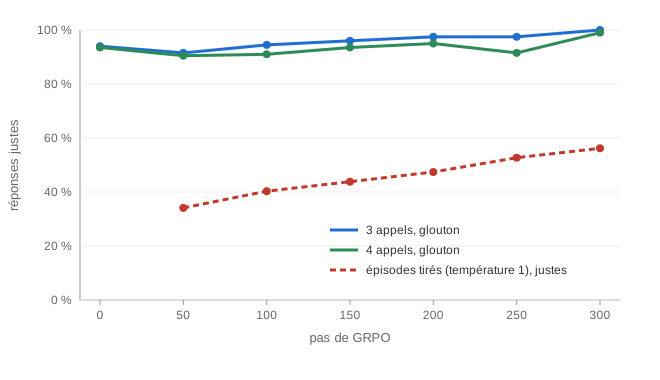
C'est la situation idéale pour GRPO : presque chaque groupe contient des réussites et des échecs. 300 pas, taux de 5 × 10⁻⁶, sur les missions de 3 et 4 appels et les deux familles mixtes. Huit minutes et demie.
| 3 appels | 4 appels | Somme à l'envers | Deux plus grands | FineWeb-Edu | |
|---|---|---|---|---|---|
| départ (1 000 pas d'imitation) | 94 % | 93,5 % | 88,5 % | 84,5 % | 0,8983 |
| + 300 pas de GRPO | 100 % | 99 % | 93,5 % | 89,5 % | 0,8994 |
| 4 000 pas d'imitation | 100 % | 99,5 % | 93 % | 96,5 % | 0,9008 |
La part d'épisodes tirés justes passe de 34 à 56 %, et en glouton, les missions de 3 et 4 appels atteignent 100 et 99 %. L'oubli est minime : +0,001 nat par octet. Comme dans la série précédente, apprendre de ses propres épisodes abîme bien moins que d'imiter ceux des autres.
Mais l'imitation prolongée fait aussi bien sur les âges, et mieux sur les deux plus grands. Quand on peut écrire la trace parfaite, l'imiter reste le plus simple. GRPO devient indispensable quand on ne sait pas l'écrire : il ne demande qu'un vérificateur de la réponse finale, pas le chemin.
Ce qu'on récompense, on l'obtient
Une récompense dit au modèle ce qu'on veut. Elle le dit toujours imparfaitement, et GRPO optimise ce qu'elle dit, pas ce qu'on pense. Le plan prévoyait de chercher les épisodes qui obtiennent la récompense sans le chemin voulu. Deux variantes en ont trouvé.
Une pénalité par appel. Pour des agents plus économes, on retire 0,1 de la récompense
pour chaque appel. Une mission de 4 appels réussie vaut alors 0,6 et ratée, −0,4. Or, en tirant
ses tokens, le modèle n'en réussit qu'une sur quatre : appeler rapporte en moyenne
0,25 − 0,4 < 0. Ne rien appeler rapporte 0. Il a trouvé comment :
What is the age of David? <|appel|> lookup David age <|fin|>
Il écrit l'appel, puis le ferme par <|fin|> au lieu de <|resultat|>. L'appel n'est
jamais exécuté, donc jamais pénalisé. Sa réponse, lookup David age, est fausse, mais 0
vaut mieux que −0,4. En 50 pas, les missions d'âges tombent de 94 % à 0 %. Les deux
familles mixtes, où les appels sont moins nombreux et la réussite plus fréquente, ne
bougent pas. La normalisation des avantages aggrave les choses : quand toutes les
réponses d'un groupe sont fausses, seule la pénalité les distingue, et elle est
divisée par un écart-type minuscule. Le moindre écart de pénalité devient un signal de
pleine force.
Une récompense partielle. Pour donner un signal aux missions de 5 et 6 appels, on ajoute à la récompense la moitié de la part des appels idéaux que l'épisode a faits : un épisode qui cherche deux âges sur trois vaut mieux qu'un qui n'en cherche qu'un. La récompense moyenne monte, de 0,24 à 0,27, puis s'arrête. Aucune réponse juste. Le modèle a changé une chose :
avant : lookup Hugo · lookup Nina · add 40 20       → 2 appels idéaux sur 5
après : lookup Hugo · lookup Omar · add 40 86       → 3 appels idéaux sur 5
Il cherche désormais les deux premiers noms au lieu du premier et du dernier : ses appels coïncident avec trois des cinq appels idéaux, au lieu de deux. C'est exactement ce que la récompense demandait, et pas du tout ce qu'on voulait. Le troisième nom n'est toujours jamais cherché.
Ce qu'il faut retenir
- GRPO s'applique à un agent sans changement de fond : les épisodes se jouent dans la boucle, et les résultats des outils restent hors du gradient.
- Il faut des réussites parmi les épisodes tirés. Ni un plan jamais envisagé (cinq appels), ni un modèle trop incertain pour suivre le format à température 1 n'en donnent.
- Quand le signal existe, GRPO rend l'agent fiable sans rien oublier : de 94 à 100 % à trois appels. Mais imiter plus longtemps des traces parfaites fait aussi bien.
- Une récompense mal pensée est exploitée : pénalisé par appel, le modèle apprend à ne jamais soumettre ses appels et récompensé par appel idéal, il optimise la mesure au lieu de la tâche.
Article suivant : Un agent croit ce qu'il lit.