Quel outil, et quand
Troisième article de la série Smallem : un agent. Précédent : Donner une calculatrice à un modèle qui ne sait pas compter.
Entraîné sur l'addition seule, le modèle de l'article précédent a appris un geste :
répondre, c'est appeler add. Il le fait pour tout, y compris pour une question dont la
réponse est dans la phrase. Un agent doit faire autre chose : choisir son outil, ou n'en
prendre aucun.
Cet article mêle plusieurs familles de missions, chacune avec son outil, et une sans outil. Puis il pose deux questions qu'on oublie volontiers quand tout marche : que fait l'agent quand un outil échoue ? Et sait-il se servir d'un outil qu'on lui décrit, au lieu de le lui apprendre ?
Cinq familles, quatre outils
| Famille | Exemple | Outil |
|---|---|---|
| addition, 2 à 4 chiffres | What is 8940 + 6046? | add |
| recopie à l'envers | Write the word backwards: needle | reverse |
| tri, 3 à 5 nombres | Sort from smallest to largest: 40 28 18 | sort |
| ville d'une personne | Where does John live? | lookup |
| lecture dans la phrase | Lucy has a black car. What color is Lucy's car? | aucun |
Les deux dernières se ressemblent exprès. Where does John live? demande un fait que seule
la table connaît : il faut lookup. Paul lives in Paris. Where does Paul live? donne le
fait dans la question : aucun outil n'est utile. Pour choisir, le modèle doit regarder si
la réponse est déjà là.
2 000 traces par famille, 14 000 en tout, 3 000 pas, les mêmes réglages qu'avant. Sept minutes.
Le bon outil, toujours
Le premier outil appelé, pour 200 missions de chaque famille, jamais vues :
| Famille | add | reverse | sort | lookup | aucun | Exactitude |
|---|---|---|---|---|---|---|
| addition, 4 chiffres | 200 | 99,5 % | ||||
| recopie à l'envers | 200 | 94,5 % | ||||
| tri | 200 | 100 % | ||||
| ville | 200 | 100 % | ||||
| lecture dans la phrase | 200 | 100 % |
Pas une erreur de choix sur 1 000 missions. Et les deux familles qui se ressemblent sont
parfaitement séparées : lookup quand le fait manque, rien quand il est là.
Les familles que le modèle de la série précédente ne savait pas faire deviennent faciles.
La recopie à l'envers passe de 0 à 94,5 % : le tokeniseur découpe needle en deux
morceaux, need et le, et eldeen en trois autres, el, de, en, qui n'ont rien en
commun avec les premiers. Retourner le mot lettre par lettre lui était impossible ;
recopier ce que rend l'outil ne l'est pas. Le tri passe de 58,5 % à 100 %. Rien n'est perdu : la lecture
reste à 100 %, et l'oubli sur FineWeb-Edu est de +0,012 nat par octet.
Le choix n'est pas difficile ici : chaque famille a sa forme de question, et le modèle associe une forme à un outil. Mais c'est exactement ce qui manquait à l'article précédent : il suffisait de lui montrer plus d'une forme.
Ce que l'outil ne fait pas à sa place
Le tri long, 6 à 8 nombres, n'est pas montré à l'entraînement. Sans outil, le modèle de la
série précédente en réussissait 2,5 %. Avec sort, 63,5 %. Mieux, mais loin des 100 % du
tri ordinaire. Ce n'est pas l'appel qui échoue : 86,5 % des épisodes appellent sort
avec exactement les bons nombres. C'est la recopie du résultat :
Sort from smallest to largest: 20 98 89 99 61 65 57
<|appel|> sort 20 98 89 99 61 65 57 <|resultat|> 20 57 61 65 89 98 99 <|assistant|>
20 57 61 65 89 99 <|fin|>
L'outil rend les sept nombres triés ; le modèle en recopie six. Il n'a jamais écrit de réponse de plus de cinq nombres, et il s'arrête tôt, comme dans la série précédente où il s'arrêtait au cinquième nombre. L'outil a déplacé la difficulté, du tri vers la recopie ; il ne l'a pas supprimée.
Quand l'outil échoue
Dans un vrai système, un outil échoue : un serveur ne répond pas, un délai expire. Que fait l'agent ? Pour le mesurer, le programme fait échouer le premier appel de chaque épisode, quel qu'il soit, avec une erreur passagère :
error: timeout, try again
Le modèle n'a jamais vu d'erreur. Il fait la seule chose qu'il a apprise : recopier le résultat.
<|appel|> add 8940 6046 <|resultat|> error: timeout, try again <|assistant|>
error: timeout <|fin|>
0 % sur les quatre familles à outil. Il a appris « la réponse est ce que l'outil a
rendu », au pied de la lettre. Le modèle de l'article précédent, entraîné sur l'addition
seule, fait pire encore : il réécrit l'appel sans <|appel|>, reçoit error: empty call,
recommence, et 196 épisodes sur 200 finissent sur le budget de 8 appels.
Pour qu'il apprenne à réagir, il faut le lui montrer. Deux sortes de traces de reprise s'ajoutent aux traces ordinaires :
- 15 % des traces reçoivent l'erreur passagère au premier appel, et l'agent refait le même appel
- 10 % commencent par un appel mal formé (un argument manquant), reçoivent
error: add takes two numbers, et l'agent écrit l'appel juste.
Une précaution compte : l'appel mal formé est écrit par le modèle dans la trace, mais il n'est pas appris. Sinon on lui apprendrait à se tromper une fois sur dix. Seule la correction est notée.
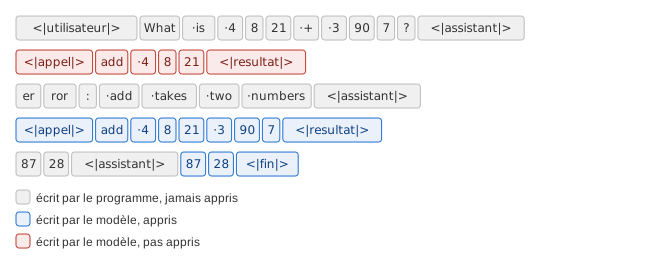
Un test vérifie qu'une trace avec un appel raté apprend exactement autant de tokens que la trace sans erreur.
Avec ces traces, l'erreur passagère ne coûte plus rien :
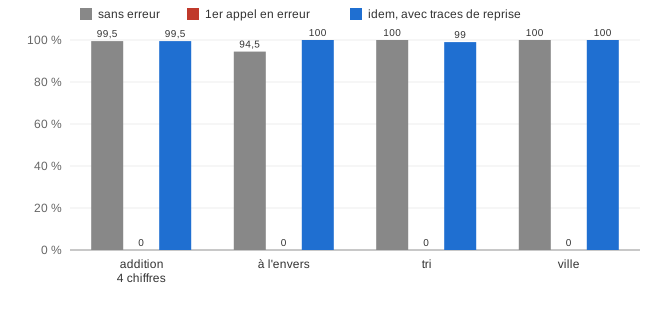
<|appel|> add 8940 6046 <|resultat|> error: timeout, try again <|assistant|>
<|appel|> add 8940 6046 <|resultat|> 14986 <|assistant|> 14986 <|fin|>
Les grands agents vont plus loin : Reflexion (Shinn et al., 2023) leur fait écrire, après un échec, ce qui n'a pas marché, et relire cette note à l'essai suivant. Le nôtre se contente de refaire l'appel.
Les traces de reprise aident aussi là où personne ne provoque d'erreur. Sur les additions de 7 et 8 chiffres, que la recopie rate parfois, le modèle se reprend après un appel tronqué. L'exactitude passe de 86,5 à 88,5 % à 7 chiffres, de 74 à 77,5 % à 8, et la recopie à l'envers de 94,5 à 100 %. Le prix : des épisodes un peu plus longs, et à 8 chiffres, 28 épisodes sur 200 qui épuisent leur budget à force de réessayer, contre aucun sans. Réessayer est une bonne idée contre une erreur passagère, moins contre une erreur que l'agent refait à l'identique.
Un outil qu'on décrit au lieu de l'apprendre
Notre modèle connaît ses outils par coeur : leurs noms sont dans ses poids. Les grands modèles fonctionnent autrement. On leur décrit les outils dans la consigne, un nom et une phrase pour chacun, et ils s'en servent sans entraînement. Un modèle de 29 millions de paramètres en est-il capable ?
La description tient en une ligne, en tête de la question :
Tools: add a b adds two numbers; reverse w writes a word backwards;
sort n1 n2 ... sorts numbers; lookup name age|city reads a fact. What is 8940 + 6046?
Pour qu'il ne puisse pas se contenter de noms appris, un second modèle est entraîné avec
des outils renommés au hasard à chaque trace, dans une liste de 24 noms sans
signification (zap, qux, frob…). Le nom de l'outil d'addition n'est plus jamais le
même : il faut le lire dans la description. À l'évaluation, les noms viennent d'une autre
liste, jamais vue (moss, brim, cusp…). Un cinquième outil s'ajoute pour les
multiplications : mul a b multiplies two numbers, que personne n'a jamais montré.
| Modèle | Consigne | Addition | À l'envers | Tri | Ville | Produit |
|---|---|---|---|---|---|---|
| noms fixes | sans description | 99,5 % | 94,5 % | 100 % | 100 % | |
| noms fixes | outils décrits, mêmes noms | 26,5 % | 0 % | 51,5 % | 0 % | 0 % |
| noms fixes | outils décrits, autres noms | 0 % | 0 % | 0 % | 0 % | 0 % |
| noms au hasard | autres noms, jamais vus | 34 % | 25,5 % | 33,5 % | 38 % | 0 % |
| noms au hasard | noms d'origine | 9 % | 8 % | 0 % | 0 % | 0 % |
| noms au hasard | sans description | 0 % | 0 % | 9 % | 1 % | 0 % |
Trois choses ressortent.
Une consigne inhabituelle suffit à le dérouter. Le modèle aux noms fixes reçoit une
description exacte de ses propres outils, avec leurs vrais noms. Il ne devrait rien avoir
à changer. Pourtant, la ville passe de 100 à 0 % : la ligne ajoutée l'entraîne dans des
répétitions (a word backwards: a word backwards: …) ou des appels sans nom
(<|appel|> 8940 6046). Il n'a jamais vu de question qui commence ainsi.
Entraîné à lire les noms, il ne les lit pas vraiment. Le modèle aux noms tirés au
hasard appelle bien un outil à chaque fois, et prend son nom dans la description. Mais
lequel ? Pour l'addition, ses premiers appels se répartissent entre brim (28), gale
(24), moss (24), hask (23)… presque uniformément. hask n'est même pas dans la
description : c'est un nom de l'entraînement. Avec quatre outils décrits, le hasard
donnerait 25 % et il fait de 25 à 38 %. Il a appris qu'un appel commence par un mot qui
ressemble à un nom d'outil, pas à relier « adds two numbers » à une addition.
Ce qu'il a appris a remplacé ce qu'il savait. Le même modèle, sans description, n'appelle
plus rien. Avec les noms d'origine, il les déforme (ad, tar, quality). Et la
multiplication reste à 0 % partout : un outil jamais montré, décrit d'une phrase, est hors
de sa portée.
C'est la limite la plus nette de cette série. Un petit modèle apprend des outils, pas à apprendre des outils. Se servir d'un outil seulement décrit demande de comprendre la description : c'est ce que le dernier article fera faire à un modèle mille fois plus grand.
Ce qu'il faut retenir
- Montré plusieurs familles, le modèle choisit le bon outil à chaque fois, et sait n'en prendre aucun quand la réponse est dans la question.
- Un outil déplace la difficulté sans la supprimer : sur le tri long, l'appel est juste, c'est la recopie du résultat qui casse.
- Sans exemples d'erreur, une erreur d'outil est recopiée comme une réponse. Avec 25 % de traces de reprise, dont l'erreur n'est pas apprise, l'agent refait l'appel et ne perd presque rien.
- Décrire les outils dans la consigne ne marche pas à cette taille : le modèle choisit un nom presque au hasard, et un outil jamais montré reste inutilisable.
Article suivant : Enchaîner les actions.