Un modèle dans une boucle
Premier article de la série Smallem : un agent, qui prolonge Smallem, après le pré-entraînement : apprendre à répondre.
À la fin de la série précédente, Smallem sait répondre à une question. Il trie une liste de nombres, retrouve un fait dans une phrase. Mais une chose lui résiste entièrement : l'addition. Sur 200 additions de deux nombres de 4 chiffres, il n'en réussit aucune. Ni le fine-tuning ni DPO n'y ont rien changé, et GRPO n'avait aucune réussite à renforcer.
Cette série prend le problème par l'autre bout. On ne lui apprend pas à additionner : on lui donne une calculatrice. C'est ce qu'on appelle un agent : un modèle de langage qui peut appeler des outils, lire leurs résultats, et recommencer jusqu'à pouvoir répondre. Derrière ce mot, il n'y a pas d'architecture nouvelle, pas de module spécial dans le réseau. Il y a une boucle. L'idée de confier à des modules ce qu'un modèle de langage fait mal, le calcul en tête, est aussi vieille que les grands modèles : c'était celle de MRKL (Karpas et al., 2022).
La boucle
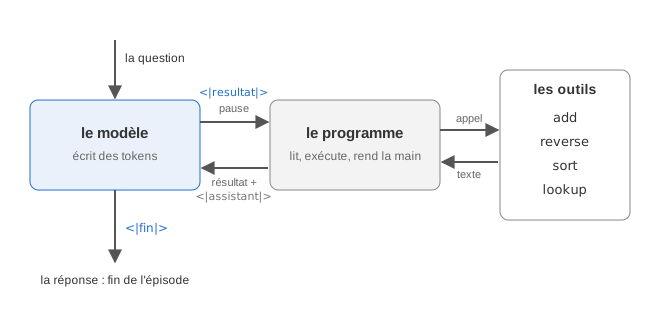
Le modèle écrit, token par token, comme toujours. Un programme le regarde faire. Quand le
modèle écrit un appel d'outil, le programme l'exécute, ajoute le résultat à la suite du
texte, et rend la main. Le modèle continue, en lisant ce résultat comme le reste de la
conversation. Quand il écrit <|fin|>, l'épisode est terminé.
Tout le reste, planifier, se corriger, se souvenir, se construit sur cette boucle. Les agents qui écrivent du code ou naviguent sur le web ne font pas autre chose : de meilleurs modèles, plus d'outils, la même boucle. Anthropic le résume dans Building effective agents (2024) : un agent est un modèle qui utilise des outils en fonction de ce qu'il observe, dans une boucle.
Il nous faut donc trois choses : un format pour écrire un appel, des outils, et une boucle qui sache s'interrompre sans tout recommencer.
Deux tokens de plus
Le format reprend l'idée des tokens de rôle. Deux tokens réservés s'ajoutent aux trois de
la série précédente, numéros 8 195 et 8 196 : <|appel|> ouvre un appel, <|resultat|>
le ferme.
<|utilisateur|> What is 4821 + 3907? <|assistant|>
<|appel|> add 4821 3907 <|resultat|> 8728 <|assistant|> 8728 <|fin|>
Le modèle écrit <|appel|>, le nom de l'outil et ses arguments, puis <|resultat|>. Le
programme reconnaît ce token, lit l'appel, l'exécute, puis écrit le résultat (8728)
suivi de <|assistant|>, qui rend la parole au modèle. Les deux nouveaux tokens reçoivent,
comme les tokens de rôle, la moyenne des lignes de la table d'embedding.
Le choix important est ailleurs : qui écrit quoi.
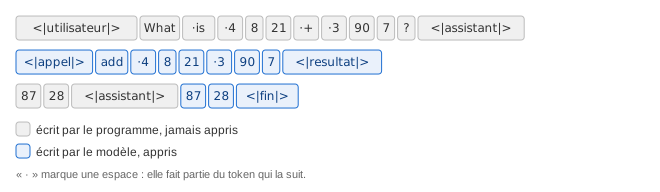
Pour l'entraînement, chaque token d'une trace porte une marque : écrit par le modèle, ou
par le programme. La perte ne porte que sur les premiers. Le modèle apprend à appeler :
le token <|appel|>, le nom de l'outil, les arguments, <|resultat|>. Il apprend à
recopier le résultat dans sa réponse. Il n'apprend jamais à prédire le résultat
lui-même. Sinon, on lui apprendrait à additionner, ce qu'il ne sait pas faire, et
qui est précisément ce qu'on veut lui éviter.
Un test le vérifie sur une trace écrite par le générateur de missions : les tokens appris
sont exactement <|appel|>, l'appel, <|resultat|>, la réponse et <|fin|>. Le
résultat de l'outil est bien dans la trace, mais pas dans la perte.
Pourquoi une calculatrice aide
Regardons comment le tokeniseur découpe les nombres. Le BPE de la première série a appris ses fusions sur FineWeb-Edu, où les nombres sont rares et variés :
"What is 4821 + 3907?"  →  What · is · 4 · 8 · 21 · + · 3 · 90 · 7 · ?
"8728"                  →  87 · 28
4821 devient trois tokens, 4, 8 et 21, et 3907 trois autres, découpés
autrement. Pour additionner, le modèle devrait aligner des chiffres qu'il ne voit pas un
par un, regroupés au hasard des fusions, et propager des retenues entre des morceaux qui
ne se correspondent pas. C'est ce qui l'a fait échouer dans la série précédente.
Mais regardez l'appel :
"add 4821 3907" → add · 4 · 8 · 21 · 3 · 90 · 7
Les mêmes tokens que dans la question, dans le même ordre. Pour écrire l'appel, le modèle n'a qu'à recopier. Et pour écrire la réponse, il recopie le résultat de l'outil, qui se découpe de la même façon dans les deux cas. Recopier, il sait le faire : c'est ce qui lui donnait 100 % sur les questions de lecture. L'outil change la nature de la tâche.
Les outils
Quatre outils, des fonctions Rust pures, sans réseau ni processus lancé :
add 4821 3907      →  8728
reverse butter     →  rettub
sort 81 5 23       →  5 23 81
lookup Paul age    →  34
lookup lit un fait dans une petite table : l'âge et la ville de seize personnes. La table
est tirée au hasard pour chaque épisode : le modèle ne peut pas l'avoir apprise par
coeur, il doit aller la lire. Un cinquième outil, mul, n'est jamais montré à
l'entraînement : il servira à voir si le modèle sait se servir d'un outil qu'on lui décrit
seulement.
Un appel mal formé ne fait pas planter l'épisode. L'outil répond par un court message,
error: add takes two numbers, que le modèle lit comme n'importe quel résultat. Il pourra
s'en servir pour se corriger, ou pas : nous le mesurerons.
Une pause dans le lot
La génération par lots de la série sur l'inférence fait avancer des centaines de séquences
ensemble, une passe du modèle pour toutes. Une séquence s'y arrête quand elle tire
<|fin|> : sa place dans le cache des clés et des valeurs est rendue.
Un agent a besoin d'autre chose : s'interrompre. Quand une séquence tire
<|resultat|>, elle ne doit pas finir, mais attendre son outil, pendant que les autres
continuent. Le Batch reçoit pour cela une liste de tokens de pause :
if Some == self.stop || length >= limit else if self.pause.contains
Une séquence en pause garde sa place dans le cache, et ne passe plus dans le modèle.
resume lui ajoute des tokens, le résultat et <|assistant|>, et la relance. Seuls ces
nouveaux tokens traversent le modèle : tout ce qu'elle avait déjà lu est dans le cache. Un
test le vérifie : une séquence mise en pause puis relancée produit exactement ce que
produirait une séquence qui aurait reçu le tout pour amorce, sans prendre une page de
cache de plus.
La boucle de l'agent est alors courte. À chaque tour, elle passe les épisodes en revue : ceux qui ont fini, ceux qui attendent un outil, qu'elle sert, puis elle fait avancer tous les autres d'un token.
loop
Deux budgets bornent un épisode : un nombre maximal d'appels (8), et un nombre maximal de tokens écrits d'un trait entre deux résultats (40). Le premier arrête un modèle qui appellerait sans fin, le second un modèle qui ne s'arrêterait plus d'écrire.
Que rapporte le cache ? Sans lui, chaque reprise relirait tout l'épisode depuis le début. Pour une mission de quatre appels, le modèle traverse 57 positions avec le cache, 215 sans : près de quatre fois plus, et l'écart croît comme le carré du nombre d'appels. L'article 4 y revient, mesures de temps à l'appui.
La ligne de base
Pour vérifier la boucle de bout en bout sans dépendre d'un grand modèle, un test entraîne un modèle minuscule, deux couches, sur une seule trace jusqu'à la savoir par coeur. Dans la boucle, il la rejoue à l'identique, appel, résultat et réponse compris, avec et sans cache.
Puis le vrai modèle, celui de la série précédente, dans la boucle, avant tout entraînement :
| Famille | Exemple | Exactitude | Épisodes avec appel |
|---|---|---|---|
| addition, 2 chiffres | What is 31 + 52? | 0 % | 0 % |
| addition, 4 chiffres | What is 8940 + 6046? | 0 % | 0 % |
| recopie à l'envers | Write the word backwards: needle | 0 % | 0 % |
| tri | Sort from smallest to largest: 40 28 18 | 58,5 % | 0 % |
| lecture dans la phrase | Lucy has a black car. What color is Lucy's car? | 100 % | 0 % |
| ville, dans la table | Where does John live? | 3,5 % | 0 % |
| somme de deux âges | What is the sum of the ages of Anna and Clara? | 0 % | 0 % |
Il n'appelle jamais rien : il n'a jamais vu <|appel|>. Il répond comme avant, 56 pour
31 + 52, et invente une ville quand on lui demande où vit John (« Republic »). Sa perte
sur FineWeb-Edu n'a pas bougé, 0,8931 nat par octet : les deux tokens ajoutés ne changent
rien à ce qu'il sait.
Ce qu'il faut retenir
- Un agent n'est pas un autre modèle : c'est un modèle dans une boucle, qui s'interrompt pour qu'un programme exécute ses appels.
- Deux tokens suffisent pour écrire un appel. Ce que le programme écrit, le résultat, n'est jamais appris.
- Une calculatrice change la nature de la tâche : le tokeniseur cache les chiffres, mais il découpe un nombre de la même façon dans la question et dans l'appel. Additionner devient recopier.
- La génération par lots sait désormais mettre une séquence en pause sans perdre son cache.
Article suivant : Donner une calculatrice à un modèle qui ne sait pas compter.