Donner une calculatrice à un modèle qui ne sait pas compter
Deuxième article de la série Smallem : un agent. Précédent : Un modèle dans une boucle.
Le modèle de la série précédente n'appelle jamais d'outil : il n'a jamais vu <|appel|>.
Il faut le lui montrer. C'est le même fine-tuning supervisé que pour lui apprendre à
répondre, sur d'autres exemples : des traces d'agent, où chaque question d'addition est
suivie de l'appel qu'un agent parfait ferait.
Toolformer (Schick et al., 2023) donnait déjà une calculatrice à un modèle de langage, et le laissait découvrir seul où l'appeler. Nous faisons plus simple : le programme écrit lui-même les traces, il sait où l'appel est utile.
Le but de l'étape : faire passer l'addition de deux nombres de 4 chiffres de 0 % à une exactitude utile, sans apprendre au modèle à additionner.
Des traces écrites par le programme
Comme les tâches de la série précédente, chaque mission est tirée d'après une graine, et le programme connaît sa réponse. Il connaît aussi sa trace idéale : la suite d'appels qui y mène. Pour une addition, un seul :
SelfAddition =>
La réponse attendue n'est pas calculée à part : le programme exécute la trace idéale avec les vrais outils, et prend le dernier résultat. Une erreur dans un outil serait donc une erreur dans la réponse attendue. Des tests vérifient les réponses contre un calcul direct.
La trace est ensuite mise en tokens avec son masque, tel que décrit dans l'article précédent : l'appel et la réponse sont appris, le résultat ne l'est pas.
L'entraînement reprend les réglages retenus dans la série précédente : 2 000 traces par longueur, de 2, 3 et 4 chiffres, soit 6 000 traces. Des lots de 32 lignes de 64 tokens, dont la moitié prise dans FineWeb-Edu pour ne pas oublier le texte ordinaire. AdamW, taux de 3 × 10⁻⁵, 1 500 pas. Deux minutes sur la carte.
De 0 à 100 %
Dès la première évaluation, au pas 250, après deux tiers de passage sur les traces :
| Pas | Validation des traces | Addition, 4 chiffres | Addition, 6 chiffres |
|---|---|---|---|
| 0 | 7,38 | 0 % | 0 % |
| 250 | 0,69 | 100 % | 94 % |
| 500 | 0,028 | 100 % | 88 % |
| 1 500 | 0,006 | 100 % | 94 % |
Cent pour cent sur 200 additions de 4 chiffres jamais vues. Et 94 % sur des nombres de 6 chiffres, que l'entraînement n'a jamais montrés.
<|utilisateur|> What is 8940 + 6046? <|assistant|>
<|appel|> add 8940 6046 <|resultat|> 14986 <|assistant|> 14986 <|fin|>
Le modèle n'a rien appris sur l'addition. Il a appris trois gestes : ouvrir un appel, recopier les deux nombres de la question, recopier le résultat. La série précédente n'avait obtenu aucune addition juste en trois méthodes et des milliers de pas et deux minutes d'imitation suffisent ici, parce que la tâche demandée est celle que le modèle sait faire.
Où la recopie casse
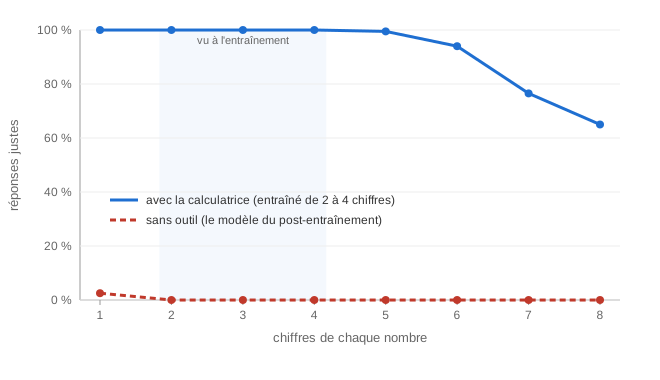
Au-delà de ce que l'entraînement a montré, l'exactitude baisse : 99,5 % à 5 chiffres, 94 % à 6, 76,5 % à 7, 65 % à 8.
| Chiffres | Exactitude | Appels idéaux | Appels par épisode | Appels sans erreur | Budget épuisé |
|---|---|---|---|---|---|
| 4 | 100 % | 100 % | 1,00 | 100 % | 0 |
| 5 | 99,5 % | 99,5 % | 1,00 | 100 % | 0 |
| 6 | 94,0 % | 94,0 % | 1,10 | 88,2 % | 3 |
| 7 | 76,5 % | 78,5 % | 1,56 | 56,7 % | 16 |
| 8 | 65,0 % | 66,5 % | 2,72 | 27,0 % | 49 |
L'exactitude suit de près la part des appels idéaux, ceux qui recopient exactement les deux nombres. Ce qui casse, c'est la recopie. Un nombre de 7 chiffres fait quatre ou cinq tokens, plus que tout ce que le modèle a vu à l'entraînement, et il lui arrive d'en perdre un :
What is 6384803 + 4029881?
<|appel|> add 6384803 402988 <|resultat|> 6787791 <|assistant|> 6787791 <|fin|>
Le dernier 1 du second nombre a disparu. L'outil calcule juste sur une entrée fausse, et
le modèle recopie le résultat sans broncher. L'erreur n'a pas disparu : elle a changé de
place, du calcul vers la recopie.
À 8 chiffres apparaît un second échec, plus inquiétant. Un appel tronqué reçoit une erreur, et le modèle part dans une boucle :
<|appel|> add 76999872 <|resultat|> error: add takes two numbers <|assistant|>
add 76999872 <|resultat|> error: empty call <|assistant|>
add 76999872 <|resultat|> error: empty call <|assistant|>
…
Il n'a jamais vu de message d'erreur. Il réécrit l'appel sans <|appel|>, reçoit une autre
erreur, recommence, jusqu'à ce que le budget de 8 appels l'arrête : 49 épisodes sur 200 à 8
chiffres finissent ainsi. Sans budget, il tournerait jusqu'à la fin du contexte. Le
budget n'est pas une précaution de principe : c'est lui qui arrête l'épisode quand le
modèle n'y arrive plus.
Recopie-t-il, ou calcule-t-il ?
L'exactitude de la réponse finale ne dit pas tout. Le modèle a-t-il appris un peu d'addition au passage, qu'il combinerait avec le résultat de l'outil ? Pour le savoir, on lui donne une calculatrice fausse, qui ajoute 1 à chaque somme :
<|appel|> add 31 52 <|resultat|> 84 <|assistant|> 84 <|fin|>
Sur 400 additions de 2 et 4 chiffres, la réponse est le résultat de l'outil dans 100 %
des cas, même pour 31 + 52. Le modèle ne vérifie rien, ne corrige rien : il délègue
entièrement. C'est ce qu'on voulait, et c'est aussi une mise en garde : un agent hérite des
erreurs de ses outils, sans le moindre filtre.
Ce que l'entraînement a abîmé
L'oubli mesuré sur FineWeb-Edu est faible : de 0,8931 à 0,9017 nat par octet, +0,009, dans la limite de 0,02 que le plan s'était fixée. Mais le reste a souffert :
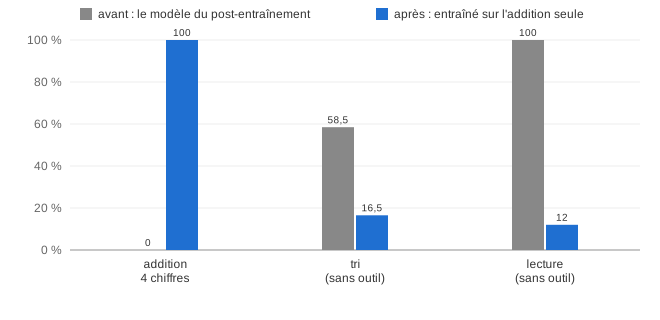
Le modèle a vu 6 000 traces qui commencent toutes par <|appel|> add. Il a appris que
répondre, c'est appeler add, et il le fait même quand la question n'a rien à voir :
Sara owns a rabbit. What animal does Sara own?
<|appel|> add rabbit <|fin|>
Le geste est appris, la décision ne l'est pas. Un agent doit savoir quand appeler un outil, et lequel : c'est l'objet du prochain article.
Ce qu'il faut retenir
- Deux minutes de fine-tuning sur des traces suffisent : l'addition de 4 chiffres passe de 0 à 100 %, celle de 6 chiffres, jamais vue, à 94 %.
- Le modèle n'a pas appris à additionner : avec une calculatrice fausse, il recopie le faux résultat dans 100 % des cas. Il délègue entièrement.
- Les erreurs changent de place : au-delà de ce qu'il a vu, il recopie mal les longs nombres. Un message d'erreur qu'il n'a jamais vu le fait tourner en rond, et seul le budget d'appels l'arrête.
- Entraîné sur un seul outil, il l'appelle pour tout. Il faut aussi lui apprendre à choisir.
Article suivant : Quel outil, et quand.