Enchaîner les actions
Quatrième article de la série Smallem : un agent. Précédent : Quel outil, et quand.
Jusqu'ici, chaque mission tenait en un appel. Un agent sert surtout quand il en faut plusieurs, et que le résultat de l'un devient l'argument du suivant : chercher un fait, puis calculer avec, puis chercher un autre fait. Chaque pas de plus est une occasion de se tromper, et une chance de perdre le fil.
Des missions à plusieurs pas
La table de faits de lookup donne un âge à chacune des seize personnes, tiré au hasard à
chaque épisode. Les missions demandent des sommes d'âges, de 1 à 6 appels :
| Appels | Question |
|---|---|
| 1 | What is the age of Paul? |
| 2 | What is the age of Paul plus 12? |
| 3 | What is the sum of the ages of Paul and Anna? |
| 4 | What is the sum of the ages of Paul and Anna plus 12? |
| 5 | What is the sum of the ages of Paul, Anna and Leo? |
| 6 | What is the sum of the ages of Paul, Anna and Leo plus 12? |
La trace idéale de la mission à 4 appels :
<|utilisateur|> What is the sum of the ages of Paul and Anna plus 12? <|assistant|>
<|appel|> lookup Paul age <|resultat|> 34 <|assistant|>
<|appel|> lookup Anna age <|resultat|> 51 <|assistant|>
<|appel|> add 34 51 <|resultat|> 85 <|assistant|>
<|appel|> add 85 12 <|resultat|> 97 <|assistant|> 97 <|fin|>
Deux autres familles mêlent des outils différents : Write the sum of 588 and 788 backwards. (add, puis reverse du résultat) et Add the two largest of: 5 81 23 40
(sort, puis add des deux derniers nombres du résultat). Dans les deux, le second appel
recopie une partie du premier résultat.
L'entraînement montre les missions de 1 à 4 appels, avec toutes les familles des articles précédents : 13 familles, 26 000 traces, 4 000 pas. Les missions de 5 et 6 appels ne sont jamais montrées : elles mesurent ce que le modèle a compris de la composition.
Jusqu'à quatre pas, sans faute
| Appels | Exactitude | Appels idéaux | Tokens par épisode |
|---|---|---|---|
| 1 | 100 % | 100 % | 21,9 |
| 2 | 100 % | 100 % | 32,1 |
| 3 | 100 % | 100 % | 47,2 |
| 4 | 99,5 % | 99,5 % | 58,1 |
| somme à l'envers (2) | 93 % | 93 % | 38,0 |
| deux plus grands (2) | 96,5 % | 94 % | 51,4 |
Quatre appels enchaînés, chacun dépendant du précédent, et 199 réponses justes sur 200.
Les rares erreurs des familles mixtes viennent toutes du même geste : recopier un résultat
intermédiaire dans l'appel suivant. Le premier appel de sum-backwards est juste à 100 %.
C'est en recopiant la somme dans reverse que le modèle se trompe parfois.
Les erreurs se composent
Si chaque appel réussit avec une probabilité p, une mission de n appels réussit avec
pⁿ, à peu près : il suffit d'une erreur pour tout perdre. Le modèle final est trop bon
pour le voir. Un modèle entraîné seulement 1 000 pas, au lieu de 4 000, le montre, surtout
quand on tire ses tokens à température 1 au lieu de prendre le plus probable :
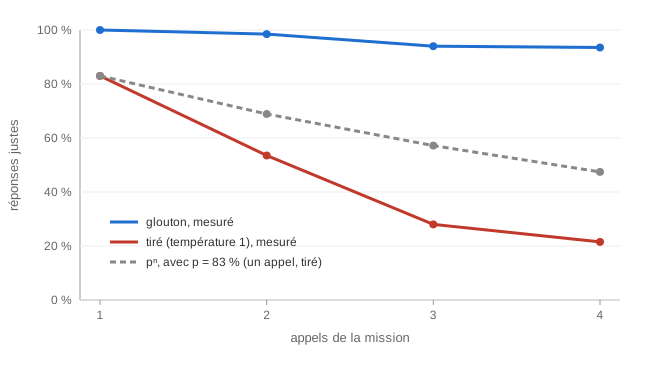
En glouton, la baisse est douce, de 100 à 93,5 % : compatible avec un p de 98 %. Tiré,
l'exactitude tombe bien plus vite que pⁿ : 21,5 % à quatre appels, quand une erreur par
pas indépendante en laisserait 47 %. Les erreurs ne sont pas indépendantes. Une recopie
fausse donne un résultat inattendu et le tour suivant, qui le lit, a d'autant plus de
chances de dérailler. Un agent ne cumule pas seulement ses erreurs : elles l'entraînent
hors de ce qu'il a vu.
Cinq pas : rien
À 5 et 6 appels, l'exactitude tombe à 0 %, sur 200 missions chacune. Pas 30 %, pas 10 % : zéro. Le modèle ne fait pourtant aucune faute de forme :
What is the sum of the ages of Hugo, Omar and Nina?
<|appel|> lookup Hugo age <|resultat|> 40 <|assistant|>
<|appel|> lookup Nina age <|resultat|> 20 <|assistant|>
<|appel|> add 40 20 <|resultat|> 60 <|assistant|> 60 <|fin|>          (attendu 146)
Il cherche Hugo, puis Nina, additionne, et répond. Omar, au milieu, a disparu. Le modèle n'a jamais vu de somme de trois personnes : il plaque sur la question le plan qu'il connaît, deux recherches et une addition, en prenant le premier et le dernier nom. Chaque appel est juste, l'arithmétique est juste. C'est le plan qui est faux.
C'est la différence entre suivre une procédure et la comprendre. Le modèle a appris une procédure par longueur de question : pour « Paul and Anna », deux recherches. Il n'a pas appris « une recherche par nom ». L'entraînement ne lui en a jamais donné l'occasion : deux exemples (un nom, deux noms) ne suffisent pas à dégager une règle.
Penser avant d'agir
ReAct (Yao et al., 2022) fait écrire au modèle, avant chaque action, une ligne de raisonnement : ce qu'il sait, ce qu'il va faire. Sur de grands modèles, cette ligne aide à planifier. Sur le nôtre ? Un second modèle est entraîné sur les mêmes traces, avec une phrase avant chaque appel :
I need the age of Paul. <|appel|> lookup Paul age <|resultat|> 34 <|assistant|>
I need the age of Anna. <|appel|> lookup Anna age <|resultat|> 51 <|assistant|>
I add 34 and 51. <|appel|> add 34 51 <|resultat|> 85 <|assistant|> 85 <|fin|>
| Sans pensée | Avec pensées | |
|---|---|---|
| 3 appels, au pas 500 | 75 % | 77 % |
| 4 appels, au pas 500 | 67 % | 69 % |
| deux plus grands, au pas 1 000 | 85 % | 93 % |
| 1 à 4 appels, fin | 99,5 à 100 % | 100 % |
| 5 et 6 appels, fin | 0 % | 0 % |
| somme à l'envers / deux plus grands, fin | 93 / 96,5 % | 92 / 97 % |
| tri long (6 à 8 nombres), fin | 61 % | 44 % |
| tokens par épisode, 4 appels | 58 | 88 |
| FineWeb-Edu, fin | 0,9012 | 0,8944 |
Les pensées accélèrent un peu l'apprentissage des familles mixtes, et c'est tout. Elles ne sauvent pas les missions à cinq appels : le modèle écrit fidèlement « I need the age of Nina. » en sautant Omar, exactement comme le modèle sans pensée. La phrase décrit le plan, elle ne le corrige pas. Elles coûtent la moitié de tokens en plus, et une dérive que l'article suivant rencontrera quand on tire les tokens au hasard.
Un effet inattendu : le modèle à pensées oublie moins FineWeb-Edu (0,8944 contre 0,9012 nat par octet). Ses traces contiennent des phrases anglaises ordinaires, plus proches du texte qu'il connaît que des suites d'appels et de nombres.
Combien de pas tiennent dans le contexte
Chaque appel coûte une douzaine de tokens sans pensée, une vingtaine avec : l'appel, le résultat, les tokens spéciaux. Le contexte du modèle en fait 512. Une consigne d'une vingtaine de tokens laisse donc la place à une quarantaine d'appels sans pensée, vingt-cinq avec. Ce n'est pas la limite qui nous arrête ici : à 5 appels, le modèle échoue avec 50 tokens. Pour les grands agents, qui lisent des fichiers entiers et des pages web, le contexte devient vite la ressource rare : ils le résument, ou n'en gardent que les derniers tours.
Le contexte coûte aussi du calcul. C'est là que sert la pause de l'article 1 : chaque reprise ne fait lire au modèle que le résultat de l'outil, le reste est dans le cache. Sans cache, chaque reprise relit tout l'épisode, et le nombre de positions lues croît comme le carré du nombre d'appels :
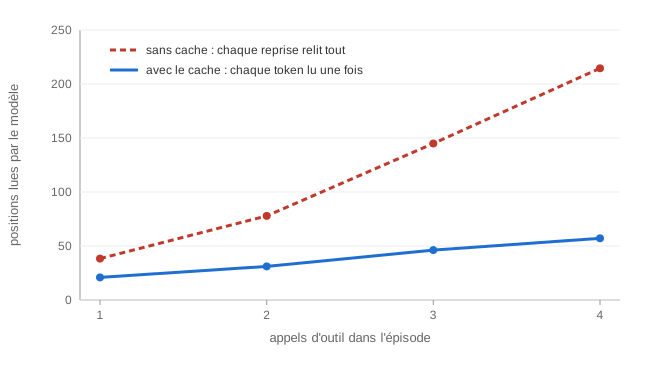
En temps, le gain est moindre que ne le laisse croire le décompte : relire un épisode se fait en une passe, tous ses tokens à la fois, alors que la génération avance d'un token par passe. Pour 200 missions de 4 appels jouées ensemble, 0,25 s avec le cache, 0,44 s sans et avec les phrases de pensée, plus longues à relire, 0,41 s contre 1,18 s. Le gain grandit avec la longueur des épisodes : c'est pour les agents qui accumulent des milliers de tokens qu'il devient indispensable.
Ce qu'il faut retenir
- Jusqu'à quatre appels enchaînés, chacun dépendant du précédent, le modèle ne se trompe presque jamais. Ses rares erreurs viennent de la recopie d'un résultat intermédiaire.
- Au-delà de ce qu'il a vu, il échoue entièrement : il plaque un plan connu sur une question nouvelle, et oublie un nom. Il a appris des procédures, pas la règle qui les engendre.
- Une phrase de pensée avant chaque appel accélère à peine l'apprentissage, ne corrige pas un mauvais plan, et coûte moitié plus de tokens.
- Les erreurs ne s'additionnent pas indépendamment : une erreur fait dérailler les tours suivants.
- Le cache transforme un coût quadratique en coût linéaire : à quatre appels, quatre fois moins de positions à lire.
Article suivant : Apprendre à agir par essais et erreurs.