Articles · Smallem : une mémoire de n-grammes
Ce que vaut un paramètre qui ne calcule pas
Quatrième article de la série Smallem : une mémoire de n-grammes.
L'article précédent a sorti la table de la carte : 2,1 milliards de paramètres pour 10 % du débit. Reste la question de la série : que valent-ils ? La série sur les lois d'échelle a mesuré ce que rapporte un paramètre du réseau, celui qui calcule. Celui-ci ne calcule pas : il attend qu'un n-gramme vienne le lire.
Toutes les mesures de cet article sont faites au budget de 10¹⁶ opérations, celui de la
série sur les lois d'échelle, avec son réseau, ses taux, sa graine, et la table seule
retenue à l'article 2. La table coûte ses opérations : 1 % pour xl, compté dans le
budget. Chaque entraînement dure trois quarts d'heure, deux à la fois sur la carte.
La taille de la table
Le modèle xl, 29 millions de paramètres, sans table puis avec des tables de plus en plus
grandes :
| Lignes par tête | Paramètres de table | Perte, nats par octet | Gain |
|---|---|---|---|
| sans table | 0 | 0,9092 | |
| 2¹⁶ | 34 millions | 0,8928 | 0,016 |
| 2¹⁸ | 134 millions | 0,8904 | 0,019 |
| 2²⁰ | 537 millions | 0,8884 | 0,021 |
| 2²², en mémoire centrale | 2,1 milliards | 0,8885 | 0,021 |
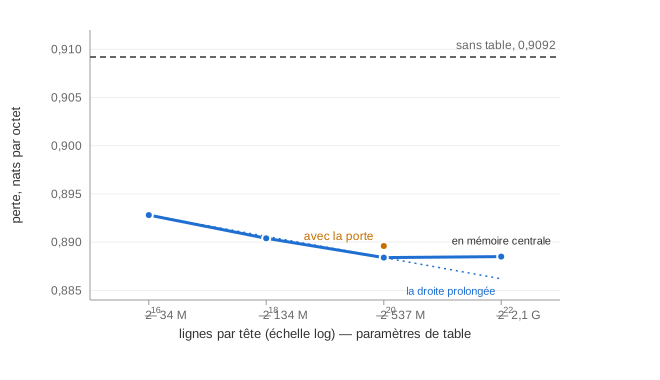
La porte d'Engram, essayée à nouveau à cette taille avec 2²⁰ lignes, ne fait pas mieux : 0,8896, au lieu de 0,8884 pour la table seule.
Engram trouve une perte qui baisse en ligne droite avec le logarithme de la taille de la table. C'est ce qu'on voit de 2¹⁶ à 2²⁰ lignes : 0,0024 puis 0,0020 de gain chaque fois que la table quadruple. Puis la droite s'arrête net : 2²² lignes ne font pas mieux que 2²⁰.
La raison est dans les données. Au budget 10¹⁶, le modèle xl lit 49 millions de tokens,
6 % du corpus. Ils contiennent 3,5 millions de bigrammes distincts, et 18,6 millions de
trigrammes, dont 13,5 millions n'apparaissent qu'une fois. Une ligne lue une seule fois
reçoit un seul pas d'AdamW : elle n'apprend presque rien. Avec 2²⁰ lignes par tête et 8
têtes, presque tous les n-grammes vus au moins deux fois ont déjà une ligne à eux dans une
des têtes. Les lignes de plus n'ont personne à servir.
L'article 1 avait compté les n-grammes du corpus entier, 141 millions de trigrammes. Mais ce qu'une table peut apprendre se compte dans ce que l'entraînement lit. Une table plus grande ne paie qu'avec un entraînement plus long.
À calcul constant
La série sur les lois d'échelle traçait, pour un budget donné, la perte selon la taille du réseau : une vallée, avec un creux, la bonne taille. Au budget 10¹⁶, ce creux était vers 15 millions de paramètres, entre les largeurs 384 et 448. La même courbe, chaque réseau recevant une table de 2²⁰ lignes par tête :
| Largeur | Réseau | Sans table | Avec table | Gain |
|---|---|---|---|---|
| 256 | 5,3 millions | 0,9298 | 0,8837 | 0,046 |
| 320 | 8,8 millions | 0,9055 | 0,8702 | 0,035 |
| 384 | 13,8 millions | 0,8974 | 0,8690 | 0,028 |
| 448 | 20,6 millions | 0,9000 | 0,8757 | 0,024 |
| 512 | 29,4 millions | 0,9092 | 0,8884 | 0,021 |
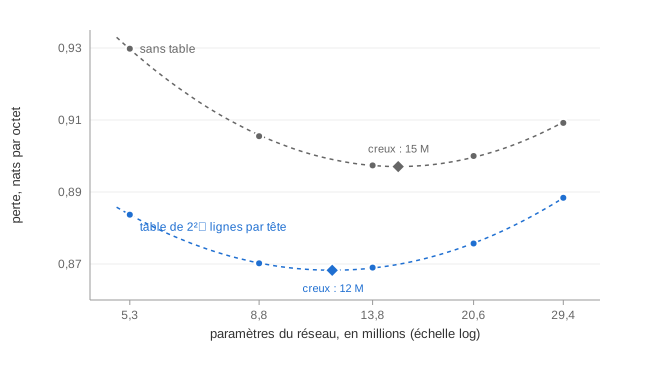
Le gain grandit à mesure que le réseau rétrécit : 0,046 nat par octet pour le plus petit,
0,021 pour le plus grand. Deux raisons s'y ajoutent. Un petit réseau sait moins de choses,
et les n-grammes que la table retient sont plus souvent des choses qu'il ignorait. Et au
même budget, il fait plus de pas : le réseau de largeur 256 lit 261 millions de tokens, le
modèle xl 49. Sa table voit cinq fois plus de n-grammes, et chacun plus souvent : la
section précédente a montré que c'est ce qui la limite.
Le creux se déplace donc vers les petits réseaux. Une parabole ajustée en log N sur chaque
courbe, comme dans la série sur les lois d'échelle, le place à 15,3 millions de paramètres
sans table et à 11,8 millions avec : un quart de moins. Une part de ce que les paramètres du
réseau apprenaient, la table le retient à leur place, et le budget libéré va à plus de
tokens.
Au creux, la perte passe de 0,8971 à 0,8683. Combien de calcul faudrait-il, sans table, pour en arriver là ? La série sur les lois d'échelle donne le creux sans table à 3 × 10¹⁶ : 0,8499. Entre les deux budgets, la perte du creux baisse de 0,099 par décade de calcul ; 0,029 en vaut 0,28, un facteur 1,9. La table vaut presque un doublement du calcul. Ses opérations sont déjà comptées dans le budget et en temps de carte, elle coûte 3 % de plus (article 3).
Au triple du calcul
Un gain mesuré à un seul budget pourrait n'être qu'un raccourci : la table apprendrait vite ce que le réseau aurait fini par apprendre seul. Le contrôle reprend donc la largeur 448 au budget 3 × 10¹⁶, trois fois plus de calcul, avec une table de 2²⁰ lignes par tête sur la carte, et une de 2²² en mémoire centrale.
| Largeur 448 | Sans table | 2²⁰ lignes par tête | 2²², en mémoire centrale |
|---|---|---|---|
| 10¹⁶ | 0,9000 | 0,8757 | |
| 3 × 10¹⁶ | 0,8524 | 0,8267 | 0,8247 |
Le gain ne fond pas : 0,024 au budget 10¹⁶, 0,026 au triple. Il est même un peu plus grand, et ce n'est pas tout. Au budget 10¹⁶, la table de 2²² lignes ne faisait pas mieux que celle de 2²⁰ mais au triple, elle passe devant, de 0,002. Le réseau de largeur 448 lit cette fois 208 millions de tokens : assez de n-grammes revus pour occuper des lignes de plus. C'est ce qu'annonçait la première section : la taille utile de la table grandit avec l'entraînement.
Le creux sans table, à ce budget, était à 0,8499. Le seul réseau de largeur 448, avec sa table en mémoire centrale, fait 0,025 de mieux : selon la pente mesurée plus haut, ce que vaudrait encore, sans table, presque deux fois plus de calcul.
Ce qu'il faut retenir
- Au budget 10¹⁶, la perte du modèle
xlbaisse en ligne droite avec le logarithme de la taille de la table jusqu'à 2²⁰ lignes par tête, puis plus du tout : ce que la table peut apprendre se compte dans les n-grammes que l'entraînement lit, et lit plusieurs fois. - Le gain est d'autant plus grand que le réseau est petit, de 0,021 à 0,046 nat par octet.
- Le creux de la courbe à calcul constant passe de 15 à 12 millions de paramètres, et sa perte baisse de 0,029 : ce que vaudrait, sans table, presque deux fois plus de calcul.
- Au triple du calcul, le gain tient, 0,026 à la largeur 448, et la table de 2²² lignes passe devant celle de 2²⁰ : plus l'entraînement lit, plus une grande table sert.
Article suivant : Générer avec une mémoire.