Articles · Smallem : une mémoire de n-grammes
Générer avec une mémoire
Cinquième et dernier article de la série Smallem : une mémoire de n-grammes.
L'article précédent a mesuré ce que la table rapporte à l'entraînement : presque un doublement du calcul. Reste à s'en servir. En génération, chaque token nouveau lit 16 lignes de 32 composantes : 2 Ko, dans une table de 2,1 Go. Que coûte cette lecture, sur la carte et sur le processeur ? Et qu'est-ce que la table a retenu ?
Toutes les mesures de cet article portent sur le modèle xl de l'article 4, entraîné au
budget 10¹⁶ avec une table de 2²⁰ lignes par tête : 29 millions de paramètres de réseau,
537 millions de table.
Ce que lit un token
Le token qu'on vient de tirer forme un bigramme avec le précédent, un trigramme avec les deux précédents. Il suffit de les hacher pour connaître les 16 lignes à lire : la mémoire n'a besoin d'aucun cache, à la différence de l'attention, qui garde les clés et les valeurs de toute la séquence. La convolution d'Engram, elle, en aurait demandé un, ses positions passées et l'article 2 l'a écartée.
Le programme throughput mesure le débit de génération selon le nombre de séquences
générées ensemble : 128 tokens par séquence, en mode glouton. L'option --memory-host sort
la table de la carte au chargement, --no-memory la coupe. La mémoire coupée désigne
ainsi le modèle entraîné avec sa table, dont on ne lit plus la table à l'usage : ses poids
ne changent pas, mais la table n'ajoute plus rien au flux. La référence est le modèle xl
entraîné au même budget sans table. Chaque débit est la moyenne de trois mesures.
Sur la carte
Modèle xl, précision mixte, tokens/s | 1 séquence | 16 | 64 |
|---|---|---|---|
| Sans table | 1 001 | 10 177 | 20 579 |
| Avec table, mémoire coupée | 979 | 10 078 | 20 518 |
| Table sur la carte | 858 (−14 %) | 9 231 (−9,3 %) | 19 436 (−5,6 %) |
| Table en mémoire centrale | 958 (−4,3 %) | 9 828 (−3,4 %) | 20 105 (−2,3 %) |
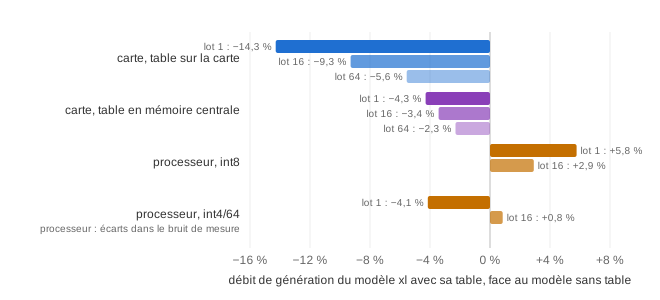
C'est le contraire de l'entraînement : la table coûte moins hors de la carte que sur elle.
Pour une séquence, un pas prend 1,00 ms sans table, et 1,17 ms avec la table sur la carte.
Les 0,17 ms de plus ne viennent pas des 2 Ko à lire. Elles viennent du chemin de lecture,
écrit pour l'entraînement : un gather_rows par table, puis des concaténations, puis la
lecture des positions. Pour 16 tables, c'est une trentaine de petites opérations, chacune
avec son lancement et sa liste d'indices copiée sur la carte. Dans un pas d'entraînement de
8 192 positions, elles ne se voient pas. Pour un token, elles pèsent un septième du pas.
En mémoire centrale, le processeur lit lui-même ses 16 lignes, en quelques microsecondes, et la carte les reçoit en une seule copie. Il reste la projection, une addition, et le hachage des n-grammes, que la mémoire coupée garde aussi : de 2,3 à 4,3 % du débit, d'autant moins que le lot est grand. Engram mesure 1,9 à 2,8 %, avec une table de 100 milliards de paramètres en mémoire centrale et un modèle bien plus lourd à calculer. Le plan prévoyait de lire les lignes du token suivant pendant que la carte calcule et à ce prix, ce n'est pas la peine.
Sur le processeur
Sur le processeur, la table est déjà en mémoire centrale. Le backend Fast de la série sur
le processeur, avec les poids du réseau en int8, puis dans sa configuration la plus
rapide, int4 par groupes de 64 sortie comprise :
Modèle xl, processeur, tokens/s | 1 séquence | 16 |
|---|---|---|
int8, sans table | 1 195 | 3 870 |
int8, avec la table | 1 264 | 3 983 |
int4/64, sans table | 2 627 | 4 357 |
int4/64, avec la table | 2 518 | 4 394 |
Les écarts sont dans le bruit, et vont dans les deux sens. Pour une séquence, trois mesures
du même modèle vont de 1 168 à 1 250 tokens par seconde en int8, de 2 308 à 2 673 en
int4. Seize lignes de 128 octets, ce sont seize défauts de cache, quelques microsecondes,
pour un pas de 0,4 à 0,8 ms.
La table coûte autre chose : de la mémoire. Le réseau quantifié tient en quelques dizaines
de mégaoctets et la table, gardée en f32, en prend 2 150. C'est de loin le premier poste du
modèle, et il resterait de la marge pour la quantifier à son tour.
Ce que retient la mémoire
Engram coupe sa mémoire après l'entraînement : le modèle garde 81 à 93 % de ses résultats en compréhension de texte, mais seulement 29 à 44 % aux questions factuelles. La table retient des faits. Un modèle de 29 millions de paramètres ne sait pas assez de faits pour poser la question ainsi. On peut en poser une voisine : quels n-grammes la table aide-t-elle à prédire ?
Le programme recall mesure la perte de validation position par position, sur 327 680
positions, de trois façons : avec la mémoire, avec la mémoire coupée, et pour le modèle
entraîné au même budget sans table. Il range chaque position selon le nombre de fois où
son trigramme, les trois derniers tokens, apparaît dans les données d'entraînement.
| Trigramme lu, vu dans l'entraînement | Positions | Sans table | Avec | Gain | Coupée |
|---|---|---|---|---|---|
| Jamais | 11,7 % | 0,8782 | 0,8633 | 0,015 | 0,9447 |
| 1 à 9 fois | 17,5 % | 0,8709 | 0,8533 | 0,018 | 0,9560 |
| 10 à 999 | 49,4 % | 0,9124 | 0,8875 | 0,025 | 1,0467 |
| 1 000 à 99 999 | 20,6 % | 0,9490 | 0,9282 | 0,021 | 1,1630 |
| 100 000 et plus | 0,7 % | 1,2305 | 1,2208 | 0,010 | 1,3848 |
| Toutes | 0,9109 | 0,8894 | 0,021 | 1,0452 |
Les pertes d'une ligne à l'autre ne se comparent pas : en nats par octet, une tranche faite de tokens courts, ponctuation et espaces, paraît chère. Ce qui se compare, c'est le gain dans chaque tranche, et celui du réseau de largeur 256, mesuré de même :
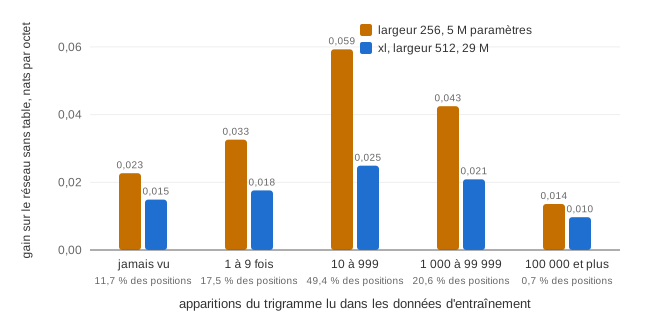
La table sert le milieu. Les trigrammes vus de 10 à 999 fois, la moitié des positions, gagnent le plus : assez fréquents pour avoir une ligne qui a appris, trop rares pour que le réseau les ait appris seul. Les plus fréquents, vus plus de 100 000 fois, gagnent le moins : le réseau les savait déjà. Les trigrammes jamais vus gagnent encore 0,015. Leur bigramme, lui, a souvent été vu, et la table en a aussi.
Et la mémoire coupée ? Le modèle ne revient pas à 0,9109, la perte du modèle sans table : il tombe à 1,0452. Couper la mémoire coûte 0,156 nat par octet, sept fois ce qu'elle rapporte ; pour le réseau de largeur 256, 0,257, cinq fois et demie. Le réseau n'a pas appris à côté de la table. Il s'est organisé autour d'elle, et ce qu'il lit, il ne sait plus le calculer. Ce sont les trigrammes vus de 1 000 à 99 999 fois qu'il a le plus abandonnés : 0,235 de perte en les coupant.
Le bilan de la série
| Article | Mesure | Sans table | Avec table |
|---|---|---|---|
| 1 | Trigrammes distincts dans le corpus | 141 millions | |
| 2 | Largeur 256, 3 × 10¹⁵, table de 67 millions | 0,9595 | 0,9258 |
| 3 | Débit d'entraînement xl, 2,1 milliards en mémoire centrale | 49 788 tokens/s | 44 846 (−9,9 %) |
| 4 | Creux à 10¹⁶, perte | 0,8971 | 0,8683 (×1,9 de calcul) |
| 4 | Largeur 448, 3 × 10¹⁶ | 0,8524 | 0,8247 |
| 5 | Génération sur la carte, une séquence, table en mémoire centrale | 1 001 tokens/s | 958 (−4,3 %) |
La série partait d'un lien : un paramètre de plus, c'est du calcul de plus. Une table de n-grammes le casse. Ses paramètres apprennent sans calculer, vivent hors de la carte, et valent, à l'entraînement, presque un doublement du calcul, pour 3 à 10 % de temps de carte.
Elle a aussi ses limites, et ce ne sont pas celles d'Engram. À notre échelle, le module d'Engram se réduit à sa table : la porte et la convolution n'apportent rien. La taille utile de la table ne se règle pas sur la mémoire disponible, mais sur ce que l'entraînement lit : au budget 10¹⁶, 2²² lignes par tête n'apprennent rien de plus que 2²⁰. Une table de 51 milliards de paramètres, comme celle de Qwen, ne se justifie que par un entraînement à sa mesure, de milliers de milliards de tokens, et non par la place disponible.
Ce qu'il faut retenir
- En génération, la table coûte de 2 à 4 % du débit de la carte quand elle vit en mémoire centrale, et de 6 à 14 % quand elle vit sur la carte : pour un token, ce sont les lancements d'opérations qui coûtent, pas les octets.
- Sur le processeur, elle ne coûte rien de mesurable et elle prend en revanche bien plus de mémoire que le réseau quantifié.
- La table aide surtout les trigrammes de fréquence moyenne, vus de 10 à 999 fois : ceux qu'une ligne peut apprendre et que le réseau n'a pas appris seul.
- Couper la mémoire coûte cinq à sept fois ce qu'elle rapporte : le réseau s'est organisé autour d'elle.
- Une table de n-grammes vaut presque un doublement du calcul, et sa taille utile se règle sur le nombre de tokens lus.