Articles · Smallem : une mémoire de n-grammes
Une mémoire qu'on consulte
Deuxième article de la série Smallem : une mémoire de n-grammes.
L'article précédent a compté les n-grammes du corpus, et mesuré ce qu'une table de comptes sait à elle seule : 1,134 nat par octet pour les trigrammes, loin derrière un Transformer. Une table de comptes ne sait faire qu'une chose, deviner le token suivant. Une table apprise peut faire mieux : donner au modèle, à chaque position, un vecteur qu'il utilise comme il l'entend.
Cet article construit cette mémoire, d'après Engram, la branche dans le modèle, et cherche ce qui compte dans sa construction.
Lire
À chaque position, la mémoire prend le bigramme et le trigramme qui y finissent, et les
hache, comme à l'article 1, vers une ligne de chacune de ses tables : K têtes par ordre,
donc 2K tables. Les lignes lues sont mises bout à bout en un vecteur e, de d_mém
composantes. Avec 8 têtes et d_mém = C = 256, chaque table a des lignes de 16
composantes.
Les lignes à lire ne dépendent que des tokens du lot. Le processeur les calcule avant la première opération du modèle, pendant qu'il prépare le lot, et la carte reçoit 16 indices par position.
Lire une ligne ne coûte pas une multiplication. C'est tout l'intérêt : une table de 2¹⁸ lignes par tête pèse 67 millions de paramètres, treize fois le réseau de largeur 256, et n'ajoute aucune opération.
La porte
Une ligne de la table sert à plusieurs n-grammes, et un même n-gramme ne veut pas dire la
même chose partout. Engram laisse donc le modèle décider, à chaque position, s'il écoute
la table. Deux projections tirent de e une clé k et une valeur v, de C
composantes chacune. La clé est comparée au flux du modèle h à cet endroit, qui sait déjà
tout le contexte :
α = σ(√±(RMSNorm(h) · RMSNorm(k) / √C))
ṽ = α v
Le produit scalaire mesure leur accord ; la racine signée, signe(g) √|g|, en adoucit les
extrêmes et la sigmoïde en fait un nombre entre 0 et 1. Une ligne qui dit autre chose que le
contexte est fermée.
La convolution
Engram ajoute ensuite une petite convolution causale, composante par composante, sur les valeurs des positions passées :
Y = SiLU(Conv1D(RMSNorm(ṽ))) + ṽ
Son noyau a 4 coefficients, espacés de 3 positions : la position t voit t, t − 3,
t − 6 et t − 9. Elle est initialisée à zéro : au départ, Y = ṽ. Puis Y s'ajoute au
flux, h ← h + Y, avant le bloc suivant.
Le tout tient en une fonction :
La porte et la convolution sont facultatives : les ablations diront ce qu'elles valent.
Générer avec la convolution
En génération, le modèle ne voit qu'un token à la fois. La mémoire a besoin des deux tokens d'avant pour former son trigramme, et la convolution des neuf dernières entrées. Le cache de la génération garde donc, pour chaque séquence, ses deux derniers tokens et les neuf dernières lignes normalisées. Un test vérifie que le modèle donne les mêmes logits avec ou sans cache, une séquence ou deux, lue d'un coup ou par morceaux.
La racine signée a un piège : sa dérivée est infinie en zéro. Le code calcule
g / (g² + 10⁻¹²)^¼, qui vaut signe(g) √|g| partout sauf dans un voisinage minuscule de
zéro, et dont la dérivée reste finie. Le gradient de tout le module est vérifié contre des
différences finies, et la convolution contre le futur : la sortie de la position t ne
change pas quand on modifie la position t + 1.
Ce qu'elle coûte
Les projections, elles, multiplient : d_mém × C multiplications-additions par token pour
v, autant pour k. Le compteur d'opérations les ajoute. Pour le réseau de largeur 256,
c'est 2 % d'opérations en plus, et donc, à budget égal, 2 % de pas en moins : 9 479 au
lieu de 9 676.
La table apprend avec AdamW, sans décroissance des poids et à cinq fois le taux de base, comme chez Engram. Les projections apprennent avec Muon, comme les autres matrices du réseau, comme chez Qwen. Comment la table apprend sans parcourir ses 67 millions de paramètres à chaque pas : c'est l'objet de l'article suivant.
Partir doucement
Un détail manque aux deux articles : la valeur de départ des lignes. Le code d'Engram les tire d'une loi normale d'écart-type 1. Essayé tel quel, au budget 3 × 10¹⁵, à la largeur 256 :
| Lignes de départ | Perte, nats par octet |
|---|---|
| Sans mémoire | 0,9595 |
| Écart-type 1 | 0,9508 |
| Écart-type 0,1 | 0,9295 |
| Écart-type 0,02 | 0,9269 |
| Écart-type 0,002 | 0,9279 |
À l'écart-type 1, les valeurs v sont seize fois plus grandes que les embeddings des
tokens, tirés à 0,02 : au départ, la mémoire noie le flux du modèle de bruit, et une part
de l'entraînement se passe à la faire taire. À 0,02, comme les embeddings, elle commence
discrète. Le gain triple, de 0,009 à 0,033 nat par octet. Toutes les mesures suivantes
partent de 0,02.
Ce qui compte
Le réseau de la série sur les lois d'échelle, à la largeur 256 (5,3 millions de paramètres), au budget 3 × 10¹⁵, avec des tables de 2¹⁸ lignes par tête. Chaque ligne du tableau est un entraînement d'une vingtaine de minutes, deux à la fois sur la carte.
| Mémoire | Perte, nats par octet | Gain |
|---|---|---|
| Aucune | 0,9595 | |
| Complète : porte, convolution, 8 têtes, ordres 2 et 3, après le bloc 1 | 0,9269 | 0,033 |
| Sans la porte | 0,9278 | 0,032 |
| Sans la convolution | 0,9257 | 0,034 |
| Sans l'une ni l'autre | 0,9258 | 0,034 |
| Bigrammes seuls | 0,9272 | 0,032 |
| 1 tête par ordre | 0,9283 | 0,031 |
| 4 têtes par ordre | 0,9274 | 0,032 |
| Avant le premier bloc | 0,9267 | 0,033 |
| Après le bloc 2, sur 4 | 0,9308 | 0,029 |
| Table au taux de base, sans le facteur 5 | 0,9303 | 0,029 |
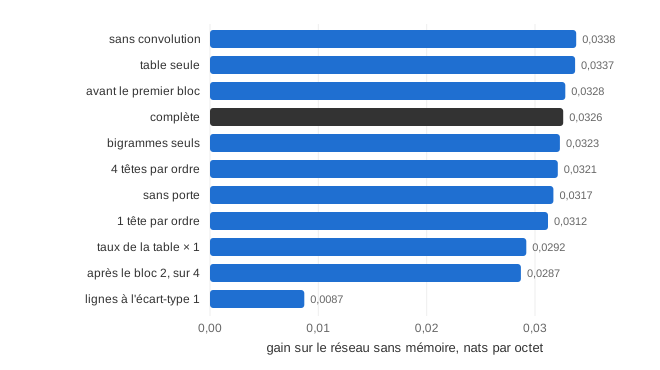
Que vaut un écart d'un millième ? Quatre de ces entraînements, refaits avec une autre graine, donnent 0,9591 au lieu de 0,9595 sans mémoire, et à 0,0003 près le même chiffre avec : 0,9269, 0,9259, 0,9281. D'une graine à l'autre, la perte ne bouge que de quelques dix-millièmes. Les écarts du tableau sont petits, mais ils ne sont pas du bruit.
Trois choses comptent, et elles valent chacune quelques millièmes :
- les lignes partent petites et apprennent vite : sans le facteur 5 du taux, le gain perd 0,004 ;
- la mémoire entre tôt : avant le premier bloc ou après lui, c'est pareil. Au milieu du réseau, 0,004 de moins. Les blocs suivants ont besoin de temps pour se servir de ce qu'elle apporte ;
- plusieurs têtes : une seule par ordre perd 0,0014, quatre 0,0005. Les têtes répartissent les collisions, comme le prévoyait l'article 1.
Le reste ne compte pas, ou compte à l'envers. Les trigrammes n'ajoutent que 0,0003 aux bigrammes : avec 2¹⁸ lignes, les tables ne servent que 43 % des trigrammes, et ce qu'ils savent de plus, le réseau le trouve dans son contexte. La porte n'ajoute rien, et la convolution retire un ou deux millièmes. Le meilleur module est le plus simple : la table, et une projection. C'est presque l'Over-Tokenized Transformer (Huang et al., 2025), qui ajoutait déjà des embeddings de n-grammes hachés à celui du token, sans porte.
C'est l'inverse d'Engram, où la porte est le composant qui compte le plus. Ses tables servent un modèle de 30 couches, au vocabulaire bien plus grand que nos 8 192 tokens : il y a bien plus de n-grammes à se partager les lignes, donc de collisions à écarter, et bien plus de contexte pour juger une ligne. Ici, un réseau de quatre blocs qui reçoit un vecteur un peu faux sait l'ignorer seul. Le gain, lui, est celui qu'annonçait Tensorizing Engram à cette échelle : 0,034 nat par octet, 3,5 % de la perte.
Toutes les mesures suivantes utilisent la table seule : sans porte ni convolution, 8 têtes par ordre, bigrammes et trigrammes, avant le bloc 1.
Ce qu'il faut retenir
- La mémoire hache le bigramme et le trigramme de chaque position vers
2Ktables, et ajoute au flux ce qu'elle y lit, à travers une porte et une convolution facultatives. - Lire ne coûte rien et les deux projections coûtent 2 % d'opérations, une seule 1 %.
- Les lignes doivent partir petites, comme les embeddings : à l'écart-type 1 d'Engram, le gain est trois fois moindre.
- À la largeur 256, une table de 67 millions de paramètres fait gagner 0,034 nat par octet, à budget égal. D'une graine à l'autre, la perte ne bouge que de 0,0004.
- La porte et la convolution d'Engram n'apportent rien à cette échelle : la table seule, avec une projection, fait aussi bien.
Article suivant : Une table hors de la carte.