Articles · Smallem : une mémoire de n-grammes
Une table hors de la carte
Troisième article de la série Smallem : une mémoire de n-grammes.
L'article précédent a branché une mémoire de 67 millions de paramètres dans un réseau qui en a 5. Elle ne coûte presque pas d'opérations. Mais une opération n'est pas une milliseconde, et Qwen garde 51 milliards de paramètres de table : où les met-on, et comment les fait-on apprendre ?
Cet article passe au modèle xl, de 29 millions de paramètres, et fait grandir sa table
jusqu'à ce qu'elle ne tienne plus sur la carte. Chaque mesure de débit y est prise seule sur
la RTX 3090, sur 360 pas.
Le gradient de toute la table
La façon la plus simple de faire apprendre la table : en faire un paramètre comme les
autres. La lecture est un gather_rows, sa dérivée un scatter_add_rows, et l'optimiseur
du modèle s'occupe du reste.
Le gradient a alors la taille de la table, et presque partout il est nul. Un lot de 16 × 512 positions lit 16 lignes par position, 131 072 en tout. Une table de 2²⁰ lignes par tête en a 16 millions : à chaque pas, 99 % du gradient est fait de zéros. Il faut pourtant l'écrire, puis AdamW lit toute la table, ses deux moments, et le gradient, et réécrit les trois premiers. Pour 537 millions de paramètres, cela fait 15 Go de mémoire à traverser à chaque pas.
Table dense, modèle xl | Tokens/s | Mémoire de la carte |
|---|---|---|
| Aucune | 49 788 | 6,4 Go |
| 2¹⁸ lignes par tête, 134 millions | 43 839 | 9,5 Go |
| 2²⁰ lignes par tête, 537 millions | 36 954 | 17,1 Go |
Le coût grandit avec la table : un quart du débit à 2²⁰ lignes. Et à 2²² lignes, la carte ne suffit plus.
Ne payer que les lignes lues
Le pas n'a besoin que des lignes lues. Avant la passe avant, la mémoire fait donc, pour chaque table, la liste de ses lignes lues, triées et sans doublon. Elle les copie dans un petit tenseur, qui entre dans la tape comme une feuille : la rétropropagation lui donne son gradient, et à lui seul. Les positions lisent ensuite dans ce petit tenseur.
/// Pour des indices `[positions, tables]`, les lignes distinctes de chaque
/// table, triées, et la place de chaque indice dans ces lignes mises bout à
/// bout, table après table.
La table n'est plus vue par l'optimiseur du modèle. Après la rétropropagation, la mémoire
garde le gradient de ses lignes, et une fois le gradient global écrêté, elle fait elle-même
son pas d'AdamW, ligne par ligne : lire les lignes et leurs moments, faire le pas, les
réécrire. Ce sont trois opérations que le backend sait déjà faire, gather_rows,
adamw_step et write_rows.
Les lignes non lues ne bougent pas, leurs moments non plus. La correction de biais d'AdamW,
qui compense le départ à zéro des moments, suit le nombre de pas de la table, et non celui
de chaque ligne : c'est le choix du SparseAdam de PyTorch. C'est une petite différence
avec la table dense, où AdamW continue de déplacer une ligne non lue par l'élan de son
premier moment. Au bout de l'entraînement de l'article 2, elle ne compte pas : 0,9262 en
dense, 0,9269 en creux.
La ligne de réserve
Le premier essai, deux entraînements à la fois sur la carte, s'est arrêté au bout de quelques minutes : plus de mémoire, 23 Go occupés. La cause n'était pas la table.
Le nombre de lignes distinctes change à chaque lot. Or la réserve de tampons du backend
garde, pour réutiliser la mémoire d'un pas à l'autre, des tampons rangés par taille : une
taille nouvelle à chaque pas, et la réserve grossit sans fin. La solution est la ligne
lines.resize(positions, spares[t]) ci-dessus. Chaque table a une ligne de plus, que rien
ne lit, et chaque liste est complétée par elle jusqu'à positions lignes, le plus qu'elle
pourrait compter. Les tenseurs du pas ont toujours la même taille. La ligne de réserve
reçoit un gradient nul : elle ne sert qu'à remplir.
Ce que coûte une table creuse
Table creuse, modèle xl | Tokens/s | Mémoire de la carte |
|---|---|---|
| Aucune | 49 788 | 6,4 Go |
| Module complet, 2¹⁶ lignes par tête | 46 032 | 7,5 Go |
| Module complet, 2¹⁸ | 46 138 | 8,6 Go |
| Module complet, 2²⁰ | 46 179 | 13,3 Go |
| Table seule, 2²⁰ | 48 463 | 12,9 Go |
Le débit ne dépend plus de la taille de la table. Le module complet coûte 7 %, mais la table n'y est pour rien : la porte et la convolution sont une vingtaine de petites opérations, normalisations, produits élément par élément, décalages, chacune avec son lancement et ses lectures. La table seule, celle que l'article 2 a retenue, ne coûte que 2,7 % : sa projection, et le tri des indices sur le processeur.
La mémoire de la carte, elle, grandit toujours : la table et ses deux moments y vivent, 12 octets par paramètre. 2²⁰ lignes en prennent 6,4 Go. 2²² lignes, 26 Go, ne tiendraient pas.
Hors de la carte
Rien n'oblige la table à vivre sur la carte. Les lignes d'un lot ne dépendent que de ses tokens, et le processeur les connaît avant le premier calcul. Il peut donc lire lui-même les lignes dans une table en mémoire centrale, les envoyer à la carte, recevoir leur gradient après la rétropropagation, et faire le pas d'AdamW de son côté.
/// Une table par tête, en mémoire centrale, avec ses moments d'AdamW.
Le pas d'AdamW se répartit sur les threads du processeur, une table par thread :
La carte reçoit, à chaque pas, 131 072 lignes de 32 composantes, 16,8 Mo, et en renvoie autant de gradient. Sur le PCIe 4.0, à 25 Go/s, c'est 1,3 ms aller et retour, pour un pas de 165 ms. Le plan prévoyait ensuite de recouvrir ces transferts par le calcul : lire les lignes du lot suivant pendant le pas courant. La mesure a montré que ce n'était pas la peine.
En mémoire centrale, modèle xl | Tokens/s | Pas | Mémoire de la carte |
|---|---|---|---|
| Aucune mémoire | 49 788 | 165 ms | 6,4 Go |
| Module complet, 2²⁰ lignes, 537 millions | 44 262 | 185 ms | 6,9 Go |
| Module complet, 2²², 2,1 milliards | 42 899 | 191 ms | 6,9 Go |
| Table seule, 2²², 2,1 milliards | 44 846 | 183 ms | 6,5 Go |
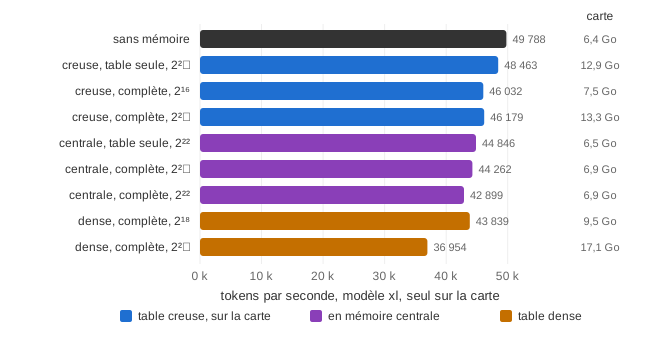
Une table de 2,1 milliards de paramètres, 73 fois le réseau, s'entraîne avec la carte sans y prendre un octet : 6,5 Go, comme sans mémoire. Elle coûte 9,9 % du débit.
Ce coût n'est pas le transfert. Face à la même table seule creuse sur la carte, le pas prend 14 ms de plus, dix fois le temps du PCIe. Et il grandit avec la table : 6 ms de plus de 2²⁰ à 2²² lignes, pour le même nombre de lignes lues. C'est la mémoire centrale elle-même. Les 131 072 lignes lues, puis réécrites avec leurs deux moments, sont éparpillées dans 26 Go : chacune est un défaut de cache, et souvent un défaut de TLB, la table qui traduit les adresses. Plus la table est grande, moins ses pages tiennent dans le TLB. C'est le même mur que le premier article de la série sur le processeur mesurait : la mémoire centrale débite 53 Go/s quand on la lit à la suite, bien moins quand on saute d'une ligne de 128 octets à une autre.
Les trois façons de stocker la table apprennent la même chose : à la largeur 256, 0,9262 en dense, 0,9269 creuse sur la carte, 0,9268 en mémoire centrale. Un test le vérifie sur une petite table, pas à pas, contre le backend de référence.
Ce qu'il faut retenir
- Le gradient dense d'une table de n-grammes est fait à 99 % de zéros, et AdamW la parcourt en entier : un quart du débit à 537 millions de paramètres.
- Ne copier que les lignes lues, et faire AdamW ligne par ligne, rend le coût indépendant de la taille de la table : 2,7 % pour la table seule.
- Les tenseurs d'un pas doivent garder la même taille : une ligne de réserve complète les listes.
- En mémoire centrale, une table de 2,1 milliards de paramètres coûte 9,9 % du débit et rien sur la carte. Le prix n'est pas le PCIe, c'est l'accès épars à la mémoire centrale.
Article suivant : Ce que vaut un paramètre qui ne calcule pas.