Articles · Smallem : une mémoire de n-grammes
Compter les n-grammes
Premier article de la série Smallem : une mémoire de n-grammes, qui prolonge Smallem : un LLM en Rust et CUDA, à partir de zéro.
Un modèle de langage paie chacun de ses paramètres deux fois : en mémoire, pour le garder, et
en calcul, pour s'en servir à chaque token. La série sur les lois d'échelle a bâti toutes ses
courbes sur ce lien : F ≈ 6 N D, des opérations proportionnelles aux paramètres. Doubler le
modèle, c'est doubler le calcul de chaque token.
Il existe pourtant des paramètres qui ne calculent presque pas. La table d'embedding en est
un : un token y choisit sa ligne, sans une multiplication. Le modèle xl en a 4,2 millions,
et elle ne coûte rien à lire. Que se passerait-il avec une table bien plus grande, indexée
non par un token mais par les deux ou trois derniers ?
C'est l'idée d'Engram (Cheng et al., 2026), chez DeepSeek : une mémoire de n-grammes, que le modèle consulte à chaque position. Qwen l'a reprise dans Qwen3.8-Flash-Next (Qwen Team, 2026), avec une seule de ces couches, au début du réseau : 51 milliards de paramètres de table, à côté de 6 milliards de paramètres actifs. Ces 51 milliards ne coûtent presque aucune opération. Ils coûtent de la mémoire, et Qwen les garde hors de la carte.
Cette série construit cette mémoire, la fait apprendre, la sort de la carte, et mesure ce que vaut un paramètre qui ne calcule pas. Avant tout cela, une question plus simple : combien de n-grammes y a-t-il à retenir ?
Des n-grammes, et où ils s'arrêtent
À la position t, le bigramme est fait des deux derniers tokens, (x_{t−1}, x_t), et
le trigramme des trois derniers. Ce sont eux que la mémoire lira : de quoi deviner le
token suivant, sachant ce qui vient d'être écrit.
Notre corpus est une suite de documents de FineWeb-Edu, séparés par un token de fin de document. Un n-gramme ne franchit pas cette frontière : la fin d'un texte sur la photosynthèse ne dit rien du début d'un texte sur Napoléon. Les tokens d'avant la fin de document y sont remplacés par la fin de document elle-même, comme le fait Qwen. Le token de fin de document est gardé : le trigramme « fin, fin, The » dit qu'un document commence par The, et c'est une information.
/// Le n-gramme suffixe le plus long qui finit à la position `t`, du plus
/// récent au plus ancien token.
Combien il y en a
Le programme ngrams compte ceux des 848 millions de tokens d'entraînement. Les bigrammes
tiennent dans un tableau de 8 192 × 8 192 compteurs. Les trigrammes sont trop nombreux
pour cela, 550 milliards de possibles : on range leurs clés, on les trie, et l'on compte
les répétitions. Le tri est réparti selon le premier token, et chaque part est triée sur son
propre thread. Le tout prend une minute et demie.
| Possibles | Présents | |
|---|---|---|
| Bigrammes | 67 millions | 12,8 millions |
| Trigrammes | 550 milliards | 141 millions |
Un bigramme possible sur cinq apparaît au moins une fois. Les trigrammes, eux, sont trop
nombreux pour une table qui leur donnerait chacun une ligne : à 512 composantes en f32,
141 millions de lignes pèseraient 290 Go.
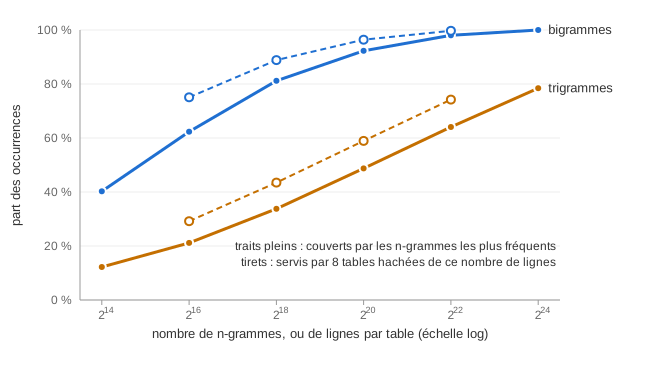
Mais tous ne se valent pas. Comme les mots, les n-grammes suivent une loi de Zipf : quelques uns reviennent sans cesse, la plupart presque jamais. La part des occurrences que couvrent les plus fréquents :
| Les plus fréquents | Bigrammes | Trigrammes |
|---|---|---|
| 2¹⁴, 16 000 | 40,3 % | 12,2 % |
| 2¹⁶, 66 000 | 62,3 % | 21,2 % |
| 2¹⁸, 262 000 | 81,2 % | 33,8 % |
| 2²⁰, 1 million | 92,3 % | 48,7 % |
| 2²², 4 millions | 98,0 % | 64,1 % |
| 2²⁴, 17 millions | 100 % | 78,5 % |
Un million de bigrammes suffisent à couvrir 92 % de ce qu'on lit. Pour les trigrammes, il en faut quatre fois plus pour en couvrir les deux tiers.
Le hachage
La mémoire ne garde pas la liste des n-grammes vus : elle les hache vers une ligne d'une table de taille fixe. Celui d'Engram est le plus simple qui soit : chaque token est multiplié par un nombre impair tiré au hasard, propre à sa place dans le n-gramme, les produits sont combinés par un « ou exclusif », et le résultat est pris modulo un nombre premier, le nombre de lignes de la table.
Deux n-grammes différents tombent parfois sur la même ligne : c'est une collision, et la ligne sert alors aux deux. Avec plus de n-grammes que de lignes, c'est inévitable. Engram en atténue l'effet par plusieurs têtes : chaque ordre a plusieurs tables, chacune avec son nombre premier et ses multiplicateurs. Deux n-grammes qui se heurtent dans l'une ont peu de chances de se heurter dans les autres.
Une ligne partagée sert surtout celui de ses n-grammes qui revient le plus : l'apprentissage la tire vers lui, plus souvent que vers les autres. La bonne mesure est donc la part des occurrences dont le n-gramme est le plus fréquent de sa ligne : celles que la table sert vraiment.
| Lignes par table | Bigrammes, une tête | Bigrammes, 8 têtes | Trigrammes, une tête | Trigrammes, 8 têtes |
|---|---|---|---|---|
| 2¹⁶ | 54,1 % | 75,1 % | 18,5 % | 29,2 % |
| 2¹⁸ | 72,4 % | 88,9 % | 29,5 % | 43,5 % |
| 2²⁰ | 85,9 % | 96,4 % | 43,2 % | 58,9 % |
| 2²² | 94,3 % | 99,7 % | 58,0 % | 74,2 % |
Avec 8 têtes, une occurrence compte comme servie si son n-gramme est le plus fréquent de sa ligne dans au moins une d'elles. Les têtes valent à peu près un facteur 4 de lignes : huit têtes de 2¹⁸ lignes servent les bigrammes presque aussi bien qu'une seule tête de 2²⁰. Et une table de 2²⁰ lignes par tête sert 96 % des bigrammes, mais seulement 59 % des trigrammes : c'est la taille où les trigrammes commencent à compter.
Ce qu'une table sait à elle seule
Avant de brancher une table dans un Transformer, que vaut-elle seule ? Le modèle bigramme de la première série prédisait le token suivant par la fréquence des paires. Le même, avec des trigrammes : la probabilité d'un token après les deux précédents est le rapport de deux comptes. Pour ne jamais donner une probabilité nulle à un trigramme absent, on la mélange à celles des bigrammes, des unigrammes et d'une loi uniforme. Les poids du mélange s'ajustent par l'algorithme EM sur la moitié de la validation, et la perte se mesure sur l'autre moitié.
| Modèle | Perte, nats par octet |
|---|---|
| Uniforme | 2,31 |
| Bigramme, par comptage | 1,317 |
| Trigramme, par comptage | 1,134 |
xl de la première série, 29 millions de paramètres | 0,882 |
| Le meilleur modèle de la série sur les lois d'échelle | 0,791 |
Les poids ajustés disent ce que vaut chaque ordre : le trigramme reçoit 74 % du mélange, le
bigramme 24 %. Une table de trigrammes sait beaucoup, sans rien comprendre : elle fait
mieux qu'un bigramme de 0,18 nat par octet. Mais il reste 0,25 nat par octet entre elle et le
modèle xl, qui voit 512 tokens de contexte et non deux.
La question de la série est donc celle-ci : un Transformer qui sait déjà tout ce qu'un trigramme sait, et bien plus, a-t-il encore quelque chose à gagner à le lire au lieu de le calculer ?
Ce qu'il faut retenir
- Les n-grammes ne franchissent pas une fin de document.
- 12,8 millions de bigrammes et 141 millions de trigrammes apparaissent dans les 848 millions de tokens ; un million de bigrammes couvrent 92 % des occurrences, mais il faut quatre millions de trigrammes pour en couvrir les deux tiers.
- Un hachage par multiplication et « ou exclusif », modulo un nombre premier. Plusieurs têtes par ordre valent environ quatre fois plus de lignes.
- À elle seule, une table de trigrammes fait 1,134 nat par octet : 0,25 de plus que le
modèle
xl.
Article suivant : Une mémoire qu'on consulte.