Articles · Smallem : les lois d'échelle sur une seule carte
La bonne taille pour un budget
Troisième article de la série Smallem : les lois d'échelle sur une seule carte. Précédent : Une famille de modèles.
Un budget de calcul fixé se partage entre deux choses : la taille du modèle et le nombre de tokens qu'il voit. Un petit modèle en voit beaucoup, un grand en voit peu, et le produit des deux, à peu près, reste le même. Entre un modèle trop petit pour apprendre ce que contient le texte et un modèle trop grand pour en avoir vu assez, la perte passe par un minimum. Où est-il ?
C'est la deuxième méthode de Hoffmann et al. (2022), l'article de Chinchilla : les courbes « à calcul constant ». On fixe un budget, on entraîne plusieurs tailles, et on lit la meilleure. Puis on recommence avec un autre budget.
La grille
Quatre budgets, espacés d'un facteur 3 environ : 10¹⁵, 3 × 10¹⁵, 10¹⁶ et 3 × 10¹⁶
opérations. Le plus petit prend quelques minutes à la carte ; le plus grand, une heure et
demie pour les tailles moyennes. Pour chacun, cinq largeurs de la famille de l'article 2,
choisies autour de l'optimum attendu, chacune avec le taux d'apprentissage que donne la loi
de cet article. --budget fixe le nombre de pas, et chaque point est un entraînement
complet.
| Largeur | Paramètres | 10¹⁵ | 3 × 10¹⁵ | 10¹⁶ | 3 × 10¹⁶ |
|---|---|---|---|---|---|
| 128 | 1,45 M | 1,0741 | |||
| 192 | 2,91 M | 1,0211 | 0,9898 | ||
| 256 | 5,27 M | 1,0137 | 0,9595 | 0,9298 | |
| 320 | 8,80 M | 1,0341 | 0,9547 | 0,9055 | 0,8852 |
| 384 | 13,8 M | 1,0883 | 0,9643 | 0,8974 | 0,8615 |
| 448 | 20,6 M | 0,9830 | 0,9000 | 0,8524 | |
| 512 | 29,4 M | 0,9092 | 0,8504 | ||
| 640 | 54,6 M | 0,8631 |
Nats par octet sur la validation. Vingt entraînements, 19,7 heures cumulées, deux à la fois sur la carte.
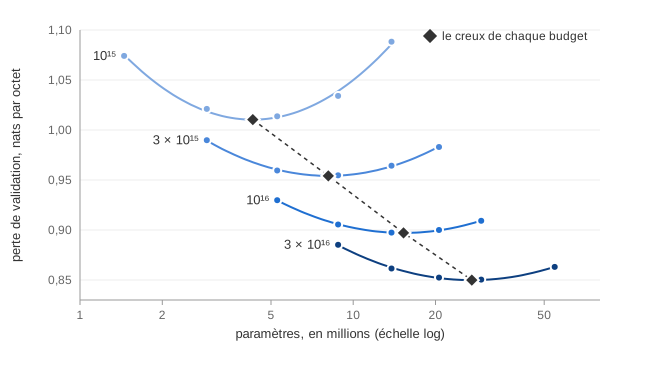
Chaque colonne a son creux, et il se déplace vers les grands modèles quand le budget grandit. Au plus petit budget, le modèle de 13,8 millions de paramètres ne voit que 10 millions de tokens, et il est le pire. Au plus grand, il serait parmi les meilleurs.
Le creux de chaque courbe
Pour situer le minimum entre deux largeurs, on fait passer une parabole par les points de chaque budget, en fonction du logarithme du nombre de paramètres, et on prend son sommet. Le nombre de tokens de l'optimum se déduit du budget et du coût par token de cette taille.
| Budget | Taille optimale | Tokens | Tokens par paramètre | Perte au creux |
|---|---|---|---|---|
| 10¹⁵ | 4,3 M | 33 M | 7,7 | 1,010 |
| 3 × 10¹⁵ | 8,1 M | 52 M | 6,4 | 0,954 |
| 10¹⁶ | 15,3 M | 94 M | 6,1 | 0,897 |
| 3 × 10¹⁶ | 27,2 M | 161 M | 5,9 | 0,850 |
L'optimum croît comme une puissance du budget F :
N_opt ∝ F^0,54 D_opt ∝ F^0,47
Hoffmann et al. trouvent 0,49 et 0,51 par cette méthode : le modèle et les données grandissent au même rythme, et c'est leur conclusion principale. Nous trouvons à peu près la même chose, avec un modèle qui grandit un peu plus vite que ses données.
Quels paramètres compter
L'article 1 a laissé une question ouverte : faut-il compter la table d'embedding ? Refaisons les paraboles en ne comptant que les paramètres hors embedding.
| Budget | Taille optimale hors embedding | Tokens par paramètre |
|---|---|---|
| 10¹⁵ | 2,0 M | 17,3 |
| 3 × 10¹⁵ | 5,1 M | 10,5 |
| 10¹⁶ | 11,6 M | 8,1 |
| 3 × 10¹⁶ | 22,5 M | 7,2 |
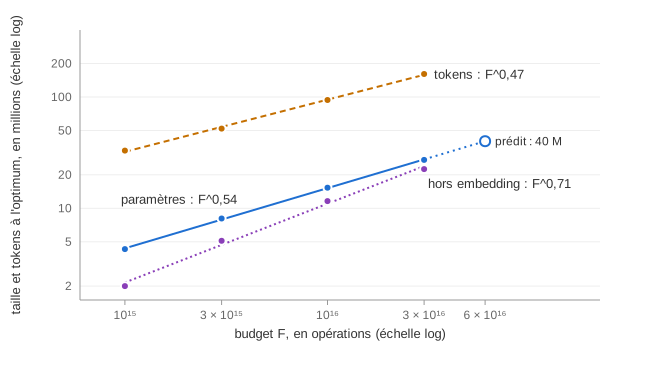
L'exposant passe de 0,54 à 0,71. C'est presque celui de Kaplan et al. (2020), 0,73, qui comptaient ainsi, alors que le premier est presque celui de Chinchilla, 0,50. Deux ans durant, l'écart entre ces deux articles a été lu comme un désaccord sur la façon d'entraîner. Pearce et Song (2024) ont montré qu'il venait surtout de là : du choix des paramètres comptés, et de la petite taille des modèles de Kaplan. Nos petits modèles le montrent au premier coup d'oeil. La table d'embedding pèse les trois quarts du plus petit et le dixième du plus grand : hors embedding, les petits modèles paraissent plus petits encore, et l'optimum semble grandir plus vite.
Le budget, lui, compte bien la table, puisqu'elle sert aussi de sortie et coûte des multiplications. Compter tous les paramètres est donc le choix cohérent, et c'est celui que recommandent Pearce et Song.
Vingt tokens par paramètre ?
Le chiffre le plus cité de Chinchilla est un rapport : environ vingt tokens par paramètre à l'optimum. Nous en trouvons 6 à 8, de moins en moins quand le budget grandit. Trois fois moins.
Nous ne savons pas dire d'où vient l'écart, et plusieurs causes sont possibles. Nos modèles vont de 1,5 à 55 millions de paramètres, ceux de Chinchilla de 70 millions à 16 milliards ; notre contexte est de 512 tokens, et notre vocabulaire de 8 192. L'optimiseur est Muon, qui tire plus de chaque token qu'AdamW (article 6) et le taux d'apprentissage suit une loi mesurée sur des entraînements courts. Le rapport dépend aussi de la façon d'ajuster : la réplication de Besiroglu et al. (2024), en refaisant la troisième méthode de Chinchilla, trouve 25,6 tokens par paramètre.
Le modèle de la première série
Le modèle xl de la première série, 29,4 millions de paramètres, a vu 94 millions de tokens
en 11 500 pas : un budget de 1,9 × 10¹⁶ opérations. Les courbes y placent l'optimum à
21,5 millions de paramètres. Le modèle était un peu trop gros, de 37 %, mais
le creux est plat : à ce facteur près, la parabole ne perd que 0,003 nat par octet.
Sa perte, 0,8823, est en revanche un peu moins bonne que ce que la famille donne à la même taille et au même nombre de tokens, environ 0,875. Il avait été entraîné au taux de 6 × 10⁻⁴, réglé pour AdamW au début de la première série. La loi de l'article 2 lui en donnerait 1,7 × 10⁻³.
Prédire
Une loi ne vaut que par ce qu'elle prédit. Avant de lancer un entraînement au double du plus grand budget, 6 × 10¹⁶, les courbes ont donné sa taille optimale, 40 millions de paramètres, soit la largeur 576 de la famille, et sa perte, 0,820. La prédiction a été écrite dans le plan avant de connaître le résultat.
L'entraînement a fait 26 619 pas, 218 millions de tokens, en un peu plus de trois heures. Sa perte : 0,8228, à 0,003 de la prédiction. Le creux s'extrapole au double du plus grand budget à mieux que l'écart d'un entraînement à l'autre.
La formule de l'article suivant, ajustée sur les mêmes points, avait prédit 0,842 pour ce même entraînement. Elle s'est trompée de 0,02, et l'article 4 dit pourquoi.
Ce qu'il faut retenir
- À budget fixé, la perte passe par un minimum en fonction de la taille ; une parabole en
ln Nle situe entre deux largeurs. - Taille et données optimales grandissent presque au même rythme,
F^0,54etF^0,47, comme dans Chinchilla. - Compter ou non la table d'embedding change l'exposant de 0,54 à 0,71 : c'est l'essentiel de l'écart entre Kaplan et Chinchilla.
- Nous trouvons 6 à 8 tokens par paramètre, pas 20, sans savoir dire pourquoi.
- Les courbes ont prédit à 0,003 près un entraînement au double du plus grand budget.
Article suivant : Une formule pour la perte.