Articles · Smallem : les lois d'échelle sur une seule carte
Une famille de modèles
Deuxième article de la série Smallem : les lois d'échelle sur une seule carte. Précédent : Compter le calcul.
Pour chercher une loi, il faut des points : beaucoup d'entraînements, de tailles et de budgets différents. Avant de les lancer, trois choses : une règle pour construire un modèle de n'importe quelle taille, une façon de donner un budget plutôt qu'un nombre de pas, et un programme qui enchaîne tous ces entraînements seul, sans qu'on ait à les lancer un par un, et qui reprend où il en était s'il est interrompu.
Une règle de forme
Un modèle se décrit par sa largeur C, son nombre de couches et son nombre de têtes. Pour
qu'une seule grandeur décrive la taille, la famille suit une règle fixe :
- des têtes de 64 composantes, donc
C / 64têtes - autant de couches que de têtes, donc
C / 64couches : le modèle est toujours 64 fois plus large qu'il n'a de couches.
Le modèle de la première série, 512 de large et 8 couches, en fait partie. Kaplan et al. ont trouvé que la forme exacte compte peu, à nombre de paramètres égal, tant que le rapport largeur sur profondeur reste dans une large plage : nous n'avons pas cherché la meilleure, seulement une règle fixe.
C | Couches | Paramètres | Hors embedding | Opérations par token |
|---|---|---|---|---|
| 128 | 2 | 1,45 M | 0,40 M | 10,2 M |
| 192 | 3 | 2,91 M | 1,33 M | 20,9 M |
| 256 | 4 | 5,27 M | 3,18 M | 37,8 M |
| 320 | 5 | 8,80 M | 6,18 M | 62,5 M |
| 384 | 6 | 13,8 M | 10,7 M | 96,7 M |
| 448 | 7 | 20,6 M | 17,0 M | 143 M |
| 512 | 8 | 29,4 M | 25,3 M | 202 M |
| 640 | 10 | 54,6 M | 49,3 M | 366 M |
| 768 | 12 | 91,3 M | 85,1 M | 604 M |
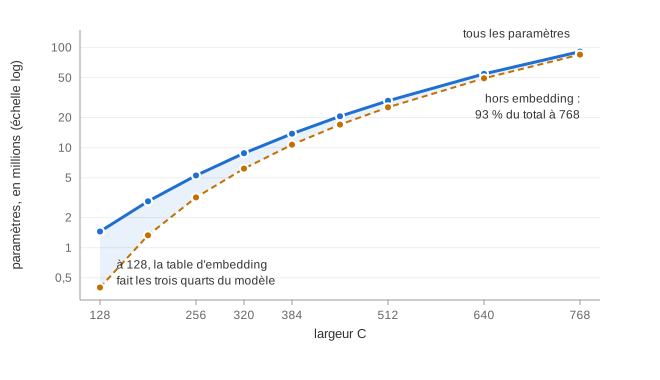
Opérations par token d'entraînement, avec des séquences de 512 tokens. Neuf tailles, de 1,4 à 91 millions de paramètres, et une table d'embedding qui pèse les trois quarts des plus petits modèles et 7 % du plus grand. La plus grande tient sur la carte avec des lots de 16 séquences de 512 tokens : 15,7 Gio.
Mesurés seuls sur la carte, en précision mixte avec Muon, les débits vont de 513 000 tokens par seconde pour la plus petite à 18 500 pour la plus grande :
C | 128 | 192 | 256 | 320 | 384 | 448 | 512 | 640 | 768 |
|---|---|---|---|---|---|---|---|---|---|
| Tokens/s | 513 300 | 295 200 | 198 200 | 121 800 | 93 100 | 62 700 | 49 900 | 30 100 | 18 500 |
| Rendement | 7,4 % | 8,7 % | 10,6 % | 10,7 % | 12,7 % | 12,6 % | 14,1 % | 15,5 % | 15,7 % |
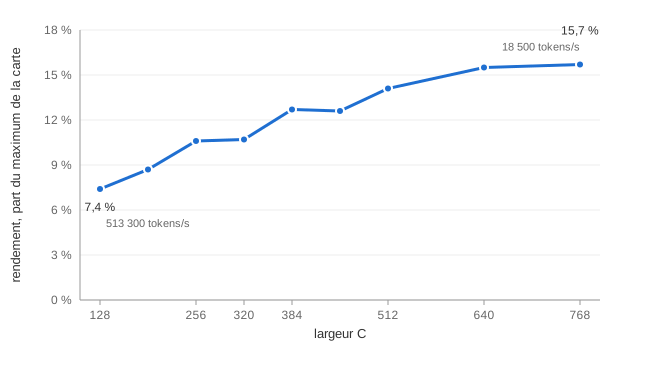
Le rendement monte avec la taille : un budget donné coûte relativement plus d'heures aux petits modèles.
train reçoit maintenant --embed et --heads, en plus de --layers.
Un budget plutôt qu'un nombre de pas
--budget 3e15 donne le calcul total, en opérations. Le nombre de pas s'en déduit par le
compte de l'article précédent, et la planification du taux, montée puis descente en
cosinus, s'y adapte toute seule, puisqu'elle est définie en fraction de l'entraînement.
C'est un point important, et l'une des leçons de la première série : la perte d'un entraînement long arrêté en route n'est pas celle d'un entraînement court mené à son terme. Le taux n'y est pas descendu. Chaque point de nos courbes sera donc un entraînement complet.
Des entraînements à la chaîne
Le programme sweep lit un plan, une ligne par entraînement :
e256-lr2e-3 --embed 256 --heads 4 --layers 4 --lr 2e-3 --budget 1e15
Il lance train pour chaque ligne, garde son journal, et note le résultat dans
results.tsv : paramètres, opérations, pas, perte finale sur les 200 lots de validation,
débit, durée. S'il est interrompu, il reprend où il en était : les lignes déjà notées ne
sont pas relancées.
Le taux d'apprentissage dépend de la taille
Un taux réglé pour le modèle de 29 millions de paramètres conviendrait-il à celui de 1,4 ou de 91 ? Pour le savoir, un balayage : trois largeurs, la plus petite, une moyenne et la plus grande, chacune entraînée 2 000 pas avec des taux espacés d'un facteur 2. 2 000 pas, c'est court : 16 millions de tokens. L'optimiseur est celui qui a gagné la première série, Muon dans sa version à quatre itérations.
| Taux | C = 128 | C = 384 | C = 768 |
|---|---|---|---|
| 3 × 10⁻⁴ | 1,4474 | 1,1934 | 1,0841 |
| 6 × 10⁻⁴ | 1,3165 | 1,1071 | 1,0168 |
| 1,2 × 10⁻³ | 1,2349 | 1,0390 | 0,9818 |
| 2,4 × 10⁻³ | 1,1950 | 1,0129 | 0,9835 |
| 4,8 × 10⁻³ | 1,1485 | 1,0153 | 1,0224 |
| 9,6 × 10⁻³ | 1,1528 | ||
| 1,92 × 10⁻² | 1,1850 |
Nats par octet sur la validation. Pour la plus petite largeur, le meilleur taux était au bord de la grille, deux taux de plus l'ont encadré.
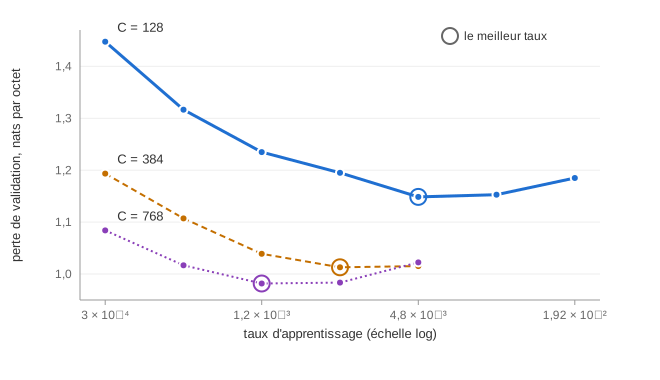
Le meilleur taux baisse quand le modèle s'élargit. En prenant, pour chaque largeur, le sommet de la parabole qui passe par le meilleur point et ses deux voisins : 6,4 × 10⁻³ à 128, 3,2 × 10⁻³ à 384, 1,6 × 10⁻³ à 768. Il est divisé par quatre quand la largeur est multipliée par six, à peu près comme une puissance −0,75 de la largeur :
taux ≈ 0,249 × C^(−0,747)
La suite utilise une version un peu plus simple, ajustée sur les meilleurs points de la
grille eux-mêmes, sans interpolation : 0,200 × C^(−0,761), qui donne des taux 20 à 25 %
plus bas. Autour de son minimum, la perte varie peu avec le taux, de l'ordre de 0,002 nat par
octet entre deux points de la grille : l'écart est sans conséquence. Et ce déplacement est
exactement le problème que l'article 5 essaiera de supprimer.
Ce qu'il faut retenir
- Une seule grandeur, la largeur, décrit la famille : têtes de 64, autant de couches que de têtes.
- Un budget en opérations fixe le nombre de pas, et chaque point est un entraînement complet.
- Le meilleur taux d'apprentissage dépend de la taille du modèle : il faut le régler pour chacune, ou trouver une paramétrisation qui le rende constant.
Article suivant : La bonne taille pour un budget.