Articles · Smallem : les lois d'échelle sur une seule carte
Prédire une nuit de calcul
Septième et dernier article de la série Smallem : les lois d'échelle sur une seule carte. Précédent : La taille du lot.
Une loi d'échelle sert à décider avant de dépenser. Six articles ont mesuré, ajusté, vérifié. Reste l'usage : fixer un budget bien plus grand que tous les précédents, en déduire le modèle à entraîner et la perte qu'il atteindra, écrire tout cela, puis lancer.
La prédiction
Le budget : 1,5 × 10¹⁷ opérations, cinq fois le plus grand de la grille, une nuit de carte. La prédiction a été écrite dans le plan avant le lancement, à partir des vingt points de la grille. Les deux méthodes ne disaient pas la même chose :
| Taille optimale | Tokens | Perte | |
|---|---|---|---|
| Courbes à calcul constant (article 3) | 65,7 M | 338 M | 0,782 |
Formule L(N, D) (article 4) | 76,5 M | 279 M | 0,822, à 90 % dans [0,804 ; 0,839] |
Le modèle entraîné est entre les deux : largeur 704, 11 couches de 11 têtes, 71,4 millions de
paramètres, le plus grand de la série après celui de largeur 768. Son taux vient de la loi de
l'article 2, 1,36 × 10⁻³, comme pour toute la grille : pas de μP, pour ne changer qu'une
chose à la fois. Le budget lui donne 315 millions de tokens, 38 500 pas. La formule lui
prédit 0,821 ; les courbes, que le creux est plat à ce facteur près de l'optimum, 0,782.
Entre l'écriture et le lancement, une seule information manquait : le contrôle de l'article 3, au double du plus grand budget, tournait encore. Il a donné raison aux courbes, à 0,003, et tort à la formule, de 0,020. La prédiction n'a pas été corrigée pour autant : on ne choisit pas sa prédiction après avoir vu le contrôle.
Le résultat
L'entraînement a fait ses 38 542 pas en 4 heures 13, à 21 600 tokens par seconde. Sa perte : 0,7905 nat par octet.
| Prédit | Écart | |
|---|---|---|
| Courbes à calcul constant | 0,782 | +0,008 |
Formule L(N, D) | 0,821, dans [0,804 ; 0,839] | −0,031 |
Les courbes tombent à 0,008 près, sous le centième que nous nous étions fixé pour le contrôle de l'article 3. La formule manque, et sort de son intervalle à 90 % de 0,014. Le plan demandait que la perte tombe dans l'intervalle prédit : seule la formule en donnait un, et elle a échoué. La validation n'est donc que partielle.
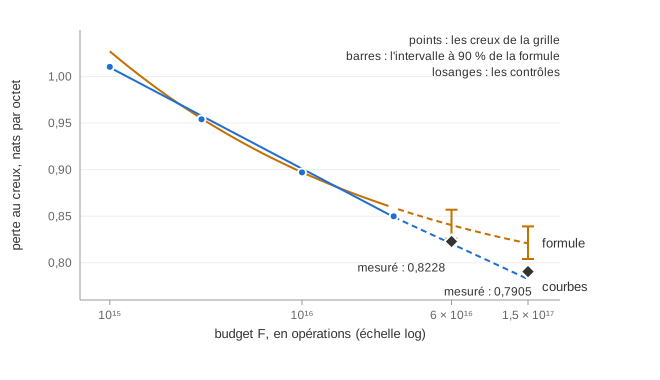
L'écart des courbes, lui, grandit avec la distance : 0,003 au double du plus grand budget,
0,008 au quintuple, et toujours dans le même sens, la perte mesurée au-dessus de la prédite.
C'est ce que l'article 4 annonçait : une loi de puissance sans plancher finit par trop
promettre. La formule, avec son plancher, reste pourtant bien plus loin, de l'autre côté.
La vérité est entre les deux, beaucoup plus près des courbes, et une loi L_opt = E + k F^−γ
ajustée sur les creux serait sans doute la prochaine chose à essayer.
Ce modèle de 71 millions de paramètres est le meilleur du projet : 0,7905, contre 0,8823 pour le modèle de la première série, pour huit fois son calcul. Prédire sa perte à moins d'un centième, avec vingt entraînements dont le plus grand coûtait cinq fois moins, voilà ce que valent les lois d'échelle à notre échelle.
Ce que la série a appris
Compter le calcul. Un pas coûte trois passes avant, et 6ND oublie l'attention : 14 % de
plus à 512 positions pour notre modèle de 29 millions de paramètres, davantage pour les plus
petits. La carte en fait 14 % de son maximum.
Régler chaque taille. Sans un taux d'apprentissage propre à chaque largeur, une loi
d'échelle mesure surtout un mauvais réglage. Le taux optimal suit C^−0,76 en paramétrisation
standard. Sous μP, il ne bouge presque plus, et une seule largeur suffit à le trouver.
La bonne taille pour un budget. Taille et données grandissent presque au même rythme,
F^0,54 et F^0,47, comme le trouvait Chinchilla. Compter la table d'embedding ou non
change l'exposant de 0,54 à 0,71 : l'essentiel de l'écart entre Kaplan et Chinchilla.
Une formule pour la perte. Elle décrit les vingt entraînements à 0,004 près, mais extrapole mal : sa forme impose plus que les données ne disent.
La taille du lot. Nos 16 séquences étaient loin sous la taille critique. 64 auraient coûté presque rien en tokens avec Muon, et fait quatre fois moins de pas.
Le modèle de la première série. Il était trop gros de 37 % pour son budget, ce qui ne coûtait que 0,003 nat par octet. Son taux d'apprentissage, réglé pour AdamW, lui coûtait davantage : il est à 0,008 de ce que la formule donne à sa taille et à ses tokens.
Ce que nous ne savons pas expliquer
- Six à huit tokens par paramètre, trois fois moins que les vingt de Chinchilla. Notre vocabulaire, notre contexte, Muon, la petite taille de nos modèles : chacun peut y être pour quelque chose, et aucune expérience de la série ne les sépare.
- La dérive du taux de Muon, en
C^−0,75sans μP, quand la condition spectrale préditC^−0,5, et que μP, qui divise parC, devrait alors trop corriger : il ne le fait pas. - La taille de lot critique, estimée à un ordre de grandeur près seulement : le bruit du gradient et la mesure directe ne disent pas la même chose à 64 et à 256 séquences.
Ce qu'il faut retenir
- Une prédiction s'écrit avant de lancer, et ne se corrige pas après le contrôle.
- Les courbes à calcul constant ont prédit, à 0,008 près, un entraînement cinq fois plus grand que tous les autres. Leur écart grandit avec la distance.
- La formule de Chinchilla décrit bien ce qu'elle a vu, et extrapole mal : elle a manqué ses deux contrôles au-delà des budgets de la grille.
- Vingt heures de mesures suffisent à choisir la taille d'un modèle et à prédire sa perte, sur une seule carte.