Articles · Smallem : les lois d'échelle sur une seule carte
Un taux pour toutes les tailles
Cinquième article de la série Smallem : les lois d'échelle sur une seule carte. Précédent : Une formule pour la perte.
Chaque point des courbes à calcul constant a demandé son taux d'apprentissage, et l'article 2 a montré que ce taux dépend de la taille du modèle. Pour une loi d'échelle, c'est une source d'erreur : un modèle mal réglé paraît plus mauvais qu'il ne l'est. Et pour un vrai laboratoire, c'est un coût : régler le taux d'un modèle de 70 milliards de paramètres demanderait plusieurs entraînements de 70 milliards.
μP (Yang et al., 2022, Tensor Programs V) propose de régler le taux une fois, sur un petit modèle, et de le garder pour les grands.
Pourquoi le meilleur taux dépend de la largeur
Une couche de largeur C calcule, pour chaque sortie, une somme de C termes. Sous la
paramétrisation standard, celle de la première série, Adam change chaque poids d'environ le
taux d'apprentissage à chaque pas, dans une direction qui, au fil des pas, devient corrélée
avec les entrées. Les C changements s'additionnent donc dans le même sens, et la sortie de
la couche bouge de C fois le taux. Un modèle m fois plus large bouge m fois plus pour le
même taux : son meilleur taux est m fois plus petit.
Ce que change μP
μP règle séparément chaque sorte de poids pour que l'amplitude des mises à jour ne dépende
plus de la largeur. Pour une largeur C = m × C₀, relative à une largeur de base C₀ :
| Poids | Initialisation | Taux (Adam) |
|---|---|---|
| matrices cachées, celles des blocs | √m fois plus petite | m fois plus petit |
| table d'embedding, gains, biais | inchangée | inchangé |
| sortie | logits divisés par m | inchangé |
C'est la table de Tensor Programs V pour Adam, ramenée à notre modèle. Deux adaptations :
- notre table d'embedding sert aussi à la sortie. La division des logits par
mjoue le rôle du multiplicateur de sortie de μP, et la table garde son initialisation et son taux - μP divise l'échelle de l'attention par
Dau lieu de√D. Dans notre famille, les têtes gardent 64 composantes et c'est leur nombre qui grandit :Dne change pas, et l'échelle non plus.
Rappel : Les logits sont les scores que le modèle donne à chacun des 8 192 tokens du vocabulaire pour la position suivante, avant que le softmax en fasse des probabilités.
Chaque paramètre porte maintenant un facteur de son taux, que respectent AdamW et Muon, et le
modèle un facteur de sortie. train --mup 128 passe un modèle en μP, relativement à la
largeur 128 : à cette largeur, rien ne change.
Le test des coordonnées
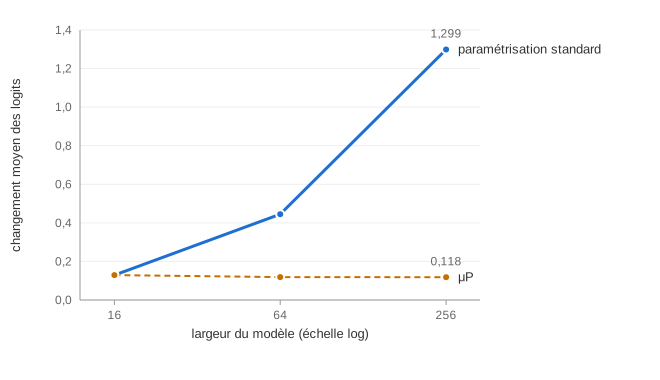
L'article de μP vérifie sa paramétrisation par un « test des coordonnées » : on regarde de combien bougent les activations après quelques pas, pour des largeurs croissantes. Sous μP, elles doivent bouger autant à toutes les largeurs. Ici, c'est un test automatique : le changement moyen des logits après trois pas d'AdamW, au même taux, pour un modèle de largeur 16, 64 et 256.
| Largeur | Paramétrisation standard | μP |
|---|---|---|
| 16 | 0,129 | 0,129 |
| 64 | 0,445 | 0,119 |
| 256 | 1,299 | 0,118 |
Sous la paramétrisation standard, les logits bougent dix fois plus quand le modèle est seize fois plus large. Sous μP, autant. Le test échoue si le rapport dépasse 1,5 sous μP, ou reste sous 3 sans.
Le balayage
Le même balayage qu'à l'article 2 : 2 000 pas, des taux espacés d'un facteur 2, Muon à quatre itérations. À la largeur 128, la largeur de base, μP ne change rien, et les points de l'article 2 resservent.
| Taux | C = 384 standard | C = 384 μP | C = 768 standard | C = 768 μP |
|---|---|---|---|---|
| 1,2 × 10⁻³ | 1,0390 | 1,1217 | 0,9818 | 1,0913 |
| 2,4 × 10⁻³ | 1,0129 | 1,0397 | 0,9835 | 0,9988 |
| 4,8 × 10⁻³ | 1,0153 | 1,0063 | 1,0224 | 0,9681 |
| 9,6 × 10⁻³ | 1,0113 | 0,9837 | ||
| 1,92 × 10⁻² | 1,0367 | 1,0115 |
Les sommets des paraboles, comme à l'article 2 :
| Largeur | 128 | 384 | 768 | De 128 à 768 |
|---|---|---|---|---|
| Paramétrisation standard | 6,4 × 10⁻³ | 3,2 × 10⁻³ | 1,64 × 10⁻³ | divisé par 3,9 |
| μP | 6,4 × 10⁻³ | 6,2 × 10⁻³ | 5,4 × 10⁻³ | divisé par 1,2 |
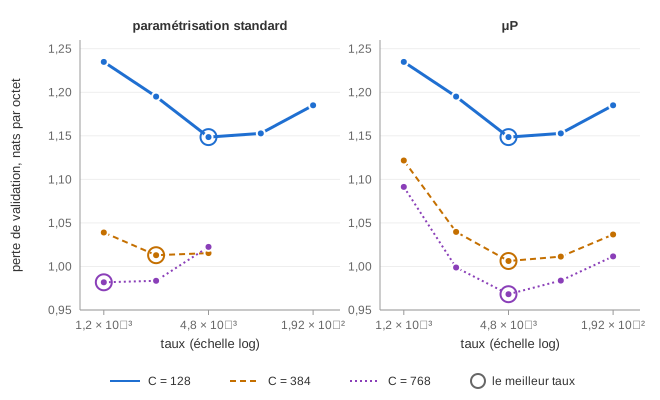
Sous μP, le meilleur taux ne bouge presque plus : 20 % sur une largeur multipliée par six, contre un facteur 4 sans. Le taux réglé sur le modèle de 1,4 million de paramètres convient à celui de 91 millions.
Et ce n'est pas tout : à leur meilleur taux, les modèles μP font mieux que les modèles standard à leur meilleur taux, de 0,007 nat par octet à la largeur 384 et de 0,014 à 768. L'écart croît avec la largeur. Tensor Programs V fait la même observation : sous μP, un modèle plus large est meilleur à réglage égal, ce qui n'est pas garanti sous la paramétrisation standard.
Et Muon ?
Muon orthogonalise la mise à jour de chaque matrice : toutes ses valeurs singulières sont égales. On pourrait croire que cela suffit à rendre la taille des mises à jour indépendante de la largeur, et que Muon n'a pas besoin de μP. Ce n'est pas le cas du nôtre, et la mesure le dit : le balayage de l'article 2 était fait avec Muon, et son meilleur taux était divisé par quatre.
La raison est dans la façon dont la première série a réglé Muon. Pour que ses mises à jour
aient la taille de celles d'AdamW, la direction orthogonalisée est multipliée par
0,2 × √max(m, n) : elle grandit avec la largeur, exactement comme le fait AdamW. μP la
corrige de la même façon.
Ce n'est pas le seul réglage possible. Yang, Simon et Bernstein (2023)
formulent la condition de μP sur la norme spectrale des mises à jour, qui doit croître comme
√(sorties / entrées) de chaque matrice. Un Muon réglé ainsi la remplirait sans facteur
supplémentaire. Selon cette théorie, notre Muon devrait d'ailleurs dériver comme 1/√C, et μP,
qui divise par C, le corriger trop. Nos mesures ne montrent ni l'un ni l'autre : sans μP, le
taux dérive plus vite, en C^(−0,75). Avec, il ne remonte pas. Le modèle n'est pas fait que de
matrices cachées : sa table d'embedding, qui sert aussi de sortie, est réglée par AdamW, et
son rôle change avec la largeur. Nous n'avons pas démêlé les parts.
Ce qu'il faut retenir
- Sous la paramétrisation standard, le meilleur taux baisse quand le modèle s'élargit : les
mises à jour de
Cpoids s'additionnent. - μP règle l'initialisation et le taux de chaque sorte de poids. Un test des coordonnées le vérifie automatiquement.
- Avec μP, le meilleur taux varie de 20 % entre 1,4 et 91 millions de paramètres, contre un facteur 4 sans, et les grands modèles sont meilleurs.
- Notre Muon a besoin de μP : il règle ses mises à jour sur celles d'AdamW.
Article suivant : La taille du lot.