Articles · Smallem : les lois d'échelle sur une seule carte
Une formule pour la perte
Quatrième article de la série Smallem : les lois d'échelle sur une seule carte. Précédent : La bonne taille pour un budget.
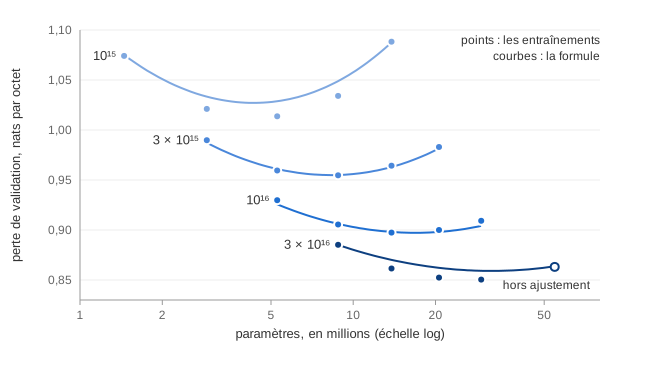
Les courbes à calcul constant de l'article 3 disent où est le creux de chaque budget. Elles ne disent rien des autres points : quelle perte donnerait un modèle de 20 millions de paramètres entraîné sur un milliard de tokens ? Pour cela, il faut une formule de la perte en fonction de la taille et des données.
La formule de Chinchilla
Hoffmann et al. (2022) proposent, dans leur troisième méthode, la forme la plus simple qui ait un sens :
L(N, D) = E + A / N^α + B / D^β
Trois termes. E est ce qu'aucun modèle ne peut apprendre : l'imprévisible du texte. A / N^α est ce que coûte un modèle trop petit, même entraîné sans fin. B / D^β est ce que
coûte un entraînement trop court, même avec un modèle infini. Les deux pénalités
s'additionnent, et chacune décroît comme une puissance.
Avec cette formule, le meilleur partage d'un budget F ≈ k N D se calcule : on minimise
A / N^α + B / D^β sous la contrainte N D = F / k, et l'on trouve N_opt ∝ F^(β/(α+β)).
Les exposants des courbes de l'article 3 deviennent un rapport entre deux constantes.
L'ajuster
Cinq constantes, vingt points. L'ajustement suit celui de l'article à la lettre.
Sur les logarithmes. On compare ln L prédit et ln L mesuré : une erreur de 1 % pèse
autant pour une perte de 1,07 que de 0,85. Les constantes sont écrites A = eᵃ, B = eᵇ,
E = eᵉ, ce qui les garde positives, et le logarithme de la somme des trois termes se
calcule sans débordement par un « log-somme-exp ».
Avec une perte de Huber. Quadratique pour les petits écarts, linéaire au-delà d'un seuil
δ = 10⁻³. Un point qui s'écarte beaucoup, un entraînement malchanceux, ne tire pas toute la
formule à lui. Les auteurs précisent qu'un seuil plus grand fait coller la formule aux petits
budgets au détriment des grands, et qu'un seuil plus petit ne change rien.
Par BFGS, depuis 4 500 points de départ. Le problème n'est pas convexe : plusieurs jeux de
constantes expliquent presque aussi bien les mêmes points, et une descente s'arrête au minimum
le plus proche. La grille est celle de l'article : α et β de 0 à 2, e de −1 à 1, a et
b de 0 à 25. Chaque départ fait sa descente, et l'on garde le meilleur. BFGS se construit
une approximation de la courbure à partir des gradients successifs, et converge en quelques
dizaines de pas. Le tout, dans scaling.rs, demande moins d'une seconde.
Vérifié sur des points dont on connaît la réponse. Un test tire 25 points d'une formule
connue, E = 0,7, α = 0,35, β = 0,3, y ajoute un bruit de 0,1 %, et demande à
l'ajustement de retrouver les exposants à 0,05 près. Il les retrouve.
Ce que l'article original avait raté
Besiroglu et al. (2024) ont voulu refaire cet ajustement. Les données de Chinchilla n'étant pas publiques, ils les ont relevées point par point sur une figure de l'article, puis ont refait le calcul. Leur formule explique bien mieux les données que celle de l'article : 98 % de leurs écarts sont plus petits que l'écart médian de l'original.
L'explication, confirmée par les auteurs de Chinchilla : ils avaient fait la moyenne des pertes de Huber au lieu de leur somme. Une moyenne sur des centaines de points est un nombre minuscule, et l'optimiseur, jugeant ses progrès trop petits, s'est arrêté trop tôt. Le même arrêt prématuré, répété sur les tirages qui mesurent l'incertitude, explique leurs intervalles de confiance bien trop étroits : il faudrait, selon la réplication, plus de 600 000 entraînements pour les obtenir. Nous sommons.
Ce que donnent nos vingt points
L(N, D) = 0,754 + 243 / N^0,481 + 8 840 / D^0,650
L'écart moyen entre la formule et les vingt entraînements est de 0,004 nat par octet, et le plus grand de 0,015. C'est l'ordre du bruit d'un entraînement à l'autre.
E | A | α | B | β | β/(α+β) | |
|---|---|---|---|---|---|---|
| Chinchilla (2022) | 1,69 | 406 | 0,34 | 411 | 0,28 | 0,46 |
| Besiroglu et al. (2024) | 1,82 | 482 | 0,35 | 2 085 | 0,37 | 0,51 |
| Smallem | 0,754 | 243 | 0,48 | 8 840 | 0,65 | 0,57 |
E ne se compare pas : la leur est en nats par token, sur leur texte et leur tokeniseur, la
nôtre en nats par octet. Nos exposants sont plus grands, les deux pénalités fondent plus
vite, mais c'est leur rapport qui compte pour le partage du budget. La formule donne un modèle
qui grandit comme F^0,57, les courbes de l'article 3 comme F^0,54 : les deux méthodes
s'accordent sur nos budgets.
L'incertitude
Vingt points pour cinq constantes, c'est peu. Pour savoir ce qu'ils déterminent vraiment, on refait l'ajustement 200 fois, chaque fois sur un tirage avec remise des vingt points : le bootstrap. Chaque tirage donne ses constantes, et leur dispersion mesure ce que les données laissent ouvert.
| Constante | Valeur | Intervalle à 90 % |
|---|---|---|
E | 0,754 | [0,672 ; 0,799] |
α | 0,481 | [0,350 ; 0,664] |
β | 0,650 | [0,390 ; 0,781] |
Les exposants sont mal connus. Ce n'est pas grave tant qu'on reste près des données : un α
plus grand va avec un A plus grand et un E plus petit, et les trois ensemble décrivent
presque la même surface. Une prédiction près des points est bien plus sûre que chacune des
constantes. Loin des points, en revanche, les jeux de constantes se séparent, et l'intervalle
de la prédiction s'élargit : de ±0,007 à 1,9 × 10¹⁶ opérations à ±0,018 à 1,5 × 10¹⁷.
Vérifier hors de l'ajustement
Une formule se juge sur des entraînements qu'elle n'a pas vus. Trois avaient été choisis
d'avance : le plus grand modèle de la grille au plus grand budget, C = 640 à 3 × 10¹⁶, retiré
de l'ajustement ; le plus grand modèle de toute la série, C = 768, 91 millions de paramètres,
entraîné 2 000 pas au meilleur taux de l'article 2 et l'entraînement de contrôle de
l'article 3, au double du plus grand budget.
| Entraînement | Mesuré | Prédit | Écart |
|---|---|---|---|
C = 640, 3 × 10¹⁶ | 0,8631 | 0,8661 | −0,003 |
C = 768, 2 000 pas | 0,9818 | 0,9743 | +0,008 |
| contrôle, 6 × 10¹⁶ | 0,8228 | 0,8426 | −0,020 |
Le plan prévoyait aussi d'ajuster la formule sur les meilleurs points de l'article 2, en plus
de la grille. Ils la dégradent. Le plus petit, C = 128 après 2 000 pas, soit 1,4 million de
paramètres et 16 millions de tokens, est 0,05 nat par octet meilleur que ce que prédit la
formule ajustée sans lui : il est dans un coin, petit modèle et peu de données, où la grille
n'a aucun point. Ajouté à l'ajustement, il tord la formule, et la prédiction pour C = 768
s'écarte alors de 0,018. Une formule ajustée ne vaut que dans la région qu'elle a vue. Les
trois entraînements de contrôle ont été prédits par la formule de la grille seule.
Deux prédictions qui divergent
Les courbes de l'article 3 prédisent aussi la perte du budget suivant, par une loi de
puissance de la perte au creux : L_opt ∝ F^−0,051. Cette loi descend sans fin, alors que la
formule a un plancher, E. Elles s'écartent déjà au plus grand budget de la grille, et de
plus en plus au-delà :
| Budget | Courbes | Formule |
|---|---|---|
| 3 × 10¹⁶ | 0,849 | 0,860 |
| 6 × 10¹⁶ | 0,820 | 0,841 |
| 1,5 × 10¹⁷ | 0,782 | 0,822 |
À 3 × 10¹⁶, le meilleur entraînement mesuré fait 0,8504 : les courbes ont raison, et la formule est trop pessimiste. Ses écarts le montrent : sur les trois meilleurs points de ce budget, elle prédit de 0,008 à 0,009 de trop. Ses écarts ne sont pas répartis au hasard ; la formule, avec ses cinq constantes, n'arrive pas à creuser assez la vallée du plus grand budget, et c'est justement là que se décide l'extrapolation.
L'entraînement de contrôle a tranché : 0,8228, à 0,003 des courbes et à 0,020 de la formule, hors de son intervalle à 90 %, [0,826 ; 0,857]. Deux contrôles sur trois sont à moins de 0,01, dont le plus grand modèle. Le troisième, le seul qui sorte des budgets de la grille, manque. La formule décrit bien ce qu'elle a vu, et extrapole mal en calcul, précisément parce qu'elle sous-estime déjà le creux de son plus grand budget.
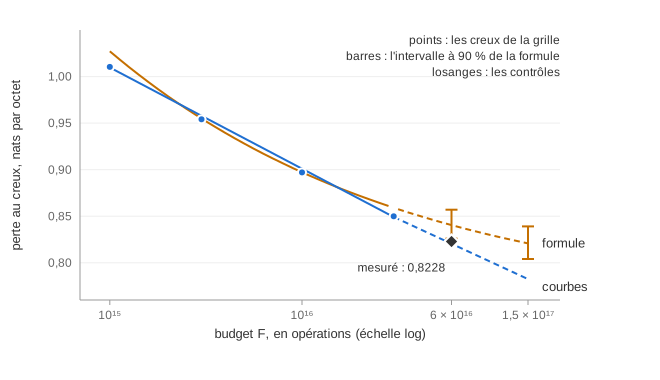
Pourquoi les courbes font-elles mieux ? Elles ne supposent rien sur la forme de la perte : chaque budget a sa parabole, et seule la perte au creux est extrapolée, par une droite en échelle logarithmique. La formule impose que la pénalité de taille et celle des données s'additionnent, avec un plancher commun. Sur deux décades de budget, cette contrainte coûte plus qu'elle n'apporte. Avec des budgets plus grands, le plancher finira par compter, et la droite des courbes par trop promettre : l'article 7 met les deux à l'épreuve, cinq fois plus loin.
Ce qu'il faut retenir
L(N, D) = E + A / N^α + B / D^βdécrit nos vingt entraînements à 0,004 nat par octet près.- L'ajustement de Chinchilla se refait : perte de Huber sur les logarithmes, BFGS depuis une grille de départs. En sommant les pertes, ce que l'original avait manqué.
- Les constantes sont mal déterminées, les prédictions proches des données beaucoup moins.
- Une formule ne vaut que là où elle a vu des points : un coin non couvert de la grille l'a mise en défaut de 0,05, et le double du plus grand budget de 0,02, quand les courbes à calcul constant y tombaient à 0,003.
Article suivant : Un taux pour toutes les tailles.