Articles · Smallem : les lois d'échelle sur une seule carte
La taille du lot
Sixième article de la série Smallem : les lois d'échelle sur une seule carte. Précédent : Un taux pour toutes les tailles.
Depuis le début du projet, un pas d'entraînement voit 16 séquences de 512 tokens : 8 192 tokens. Ce nombre n'a jamais été justifié. La première série a jugé Muon sur cette taille de lot, puis l'a réhabilité quand le budget a changé. Faudrait-il des lots plus gros ? Plus petits ? Et jusqu'où un lot plus gros aide-t-il ?
Deux façons de dépenser des tokens
Un lot plus gros donne un gradient plus précis : la moyenne de plus d'exemples. Avec un lot
de B exemples, le gradient mesuré est le vrai gradient G, celui de toute la
distribution, plus un bruit dont la variance est divisée par B.
Tant que ce bruit domine, doubler le lot revient presque à faire deux pas : il faut deux fois moins de pas pour atteindre la même perte, et autant de tokens. Le lot plus gros ne coûte rien, et il va plus vite, puisque la carte traite mieux les gros produits. Quand le gradient est déjà précis, doubler le lot ne fait plus gagner de pas : on dépense deux fois plus de tokens pour le même chemin.
McCandlish et al. (2018) mettent ce compromis en
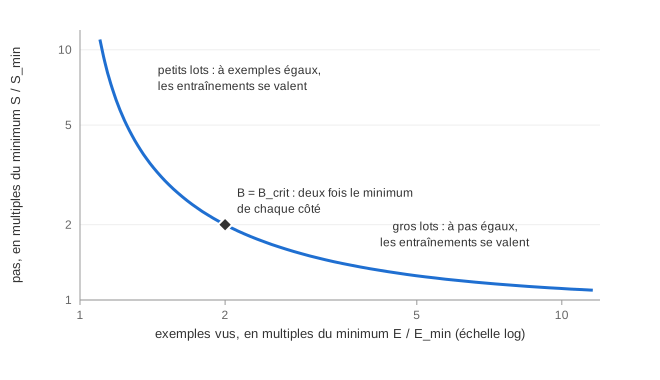
équation. Pour atteindre une perte donnée, il faut S pas et E = B × S exemples, et les
deux sont liés par
(S / S_min − 1) × (E / E_min − 1) = 1
où S_min est le nombre de pas avec un lot infini, et E_min le nombre d'exemples avec un
lot minuscule. La taille de lot critique est leur rapport, B_crit = E_min / S_min. À
ce lot, on paie deux fois le minimum des deux côtés : deux fois plus de pas qu'avec un lot
infini, deux fois plus d'exemples qu'avec un lot minuscule. Très en dessous, les
entraînements se ressemblent à exemples égaux et très au-dessus, à pas égaux.
Le bruit du gradient
Trouver B_crit ainsi demande beaucoup d'entraînements complets, à toutes les tailles de
lot, chacun avec son taux. L'article propose un raccourci : le bruit du gradient, le
rapport de sa variance à sa norme,
B_bruit = tr(Σ) / |G|²
tr(Σ) est la variance du gradient d'un seul exemple, sommée sur tous les paramètres, et
|G|² la norme du vrai gradient. C'est le nombre d'exemples à partir duquel le bruit d'un
lot devient plus petit que le signal. Les auteurs le comparent à B_crit sur huit tâches,
des chiffres manuscrits à Dota, où B_crit varie de six ordres de grandeur : B_bruit le
prédit à un ordre de grandeur près.
Ni G ni Σ ne se mesurent directement : on ne voit que des gradients de lots. Mais la
norme au carré d'un gradient de lot vaut en moyenne |G|² + tr(Σ) / B. En mesurant cette
norme à deux tailles de lot, b et B, on a deux équations pour deux inconnues :
|G|²   ≈ (B |g_B|² − b |g_b|²) / (B − b)
tr(Σ)  ≈ (|g_b|² − |g_B|²) / (1/b − 1/B)
C'est l'estimateur de l'annexe A de l'article. Le programme noise le calcule sur un modèle
entraîné : K micro-lots de b séquences, la norme de chacun de leurs gradients, puis
celle de leur moyenne, qui est le gradient d'un lot de K × b. Rien de plus que
l'accumulation de gradients qui existe déjà.
Ce que mesure noise
Avec 128 micro-lots de 4 séquences, soit un grand lot de 512 :
| Modèle | Perte | tr(Σ) | |G|² | B_bruit |
|---|---|---|---|---|
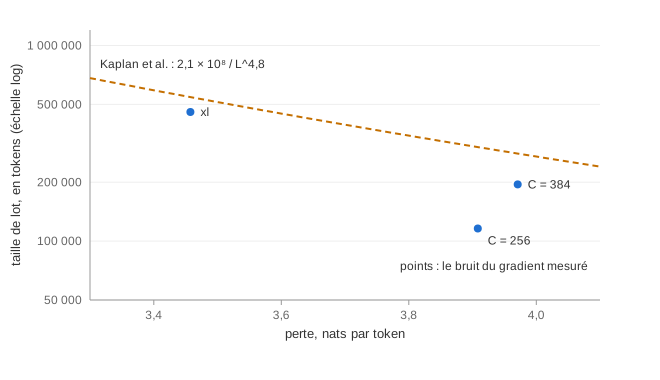
| xl, fin de la première série | 0,882 | 19,2 | 0,0215 | 893 séquences, 457 000 tokens |
| C = 384, 2 000 pas (article 2) | 1,013 | 6,02 | 0,0158 | 381 séquences, 195 000 tokens |
| C = 256, 4 096 pas (ci-dessous) | 0,997 | 3,76 | 0,0166 | 226 séquences, 116 000 tokens |
Une première mesure du modèle xl, avec 32 micro-lots seulement, avait donné 1 006
séquences : l'estimateur est bruité lui-même, et l'ordre de grandeur seul compte.
Notre lot de 16 séquences est 14 à 55 fois plus petit que ce bruit. Selon la théorie, nos entraînements sont tous dans le régime où chaque token compte : un lot plus gros ne changerait presque pas la perte à tokens égaux, et ferait moins de pas.
Le bruit grandit pendant l'entraînement : quand la perte baisse, le vrai gradient
rétrécit plus vite que sa variance, et il faut plus d'exemples pour le distinguer. Le
modèle xl, plus grand et entraîné plus longtemps, descend plus bas, et son bruit est plus de
deux fois plus grand. Selon McCandlish et al., la taille du modèle compte surtout par là :
par la perte qu'il atteint.
Kaplan et al. (2020) en ont tiré une loi,
B_crit ≈ 2,1 × 10⁸ / L^4,8 tokens, avec L la perte en nats par token. Nos pertes,
converties avec nos 3,92 octets par token, donnent 570 000 tokens pour xl et 300 000
pour le modèle de largeur 384 : du même ordre que nos mesures. La coïncidence ne prouve pas
grand-chose, avec un autre texte et un autre tokenizer, mais elle rassure.
La mesure directe
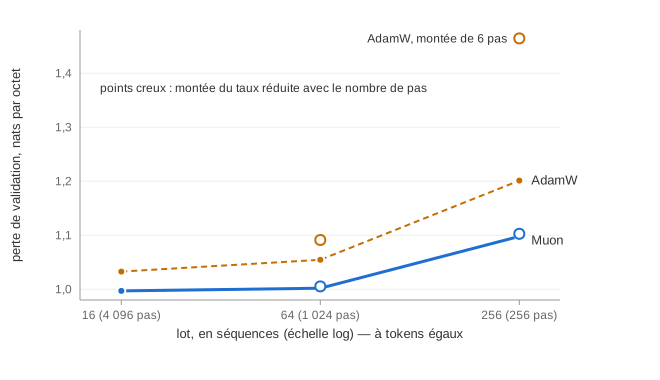
Le bruit est une prédiction. Pour la vérifier, il faut l'expérience qu'il évite : entraîner le même modèle, à tokens égaux, avec des lots de tailles différentes, chacun à son meilleur taux. Le modèle de largeur 256, 5,3 millions de paramètres, voit 33,5 millions de tokens : 4 096 pas de 16 séquences, 1 024 pas de 64, ou 256 pas de 256. Trois taux pour chaque taille, espacés d'un facteur 2, avec AdamW et avec Muon.
| Lot | 16 séquences | 64 | 256 |
|---|---|---|---|
| Pas | 4 096 | 1 024 | 256 |
| Muon | 0,9968 | 1,0018 | 1,0978 |
| AdamW | 1,0326 | 1,0544 | 1,2011 |
Nats par octet, au meilleur taux de chaque case. Passer de 16 à 64 séquences coûte presque rien avec Muon, 0,005 nat par octet, et un peu plus avec AdamW, 0,022. Passer à 256 coûte cher : 0,10 et 0,17.
Combien de tokens ces pertes représentent-elles ? Le même modèle, entraîné avec des lots de 16 pour quatre budgets, donne la perte en fonction du nombre de tokens, et l'on peut lire à quel nombre de tokens un lot de 16 atteint chaque perte. Avec Muon, le lot de 64 vaut 31 millions de tokens d'un lot de 16, 7 % de moins que les 33,5 millions qu'il a vus. Le lot de 256 n'en vaut que 11 millions, trois fois moins.
Dans le modèle de McCandlish et al., le lot de 64 donne un lot critique d'environ 700 séquences, et celui de 256, d'environ 90. Un seul nombre ne décrit pas les deux. Le bruit grandit pendant l'entraînement : au début, la perte est haute, le bruit petit, et un gros lot gaspille ses tokens. Vers la fin, il ne gaspille plus rien. 256 pas, c'est aussi très peu : il faut un nombre minimal de pas pour atteindre une perte, et ce nombre-là, aucun lot ne le réduit. Le bruit mesuré sur le modèle final, lui, vaut 226 séquences. Il tombe entre les deux, à l'ordre de grandeur près, ce que promettait l'article.
La montée du taux compte
Un premier passage avait réduit la montée du taux en proportion du nombre de pas : 100 pas pour le lot de 16, 25 pour celui de 64, 6 pour celui de 256. AdamW s'y est effondré :
| Lot | 64, montée de 25 pas | 64, montée de 100 | 256, montée de 6 | 256, montée de 100 |
|---|---|---|---|---|
| Muon | 1,0052 | 1,0018 | 1,1026 | 1,0978 |
| AdamW | 1,0911 | 1,0544 | 1,4644 | 1,2011 |
AdamW divise chaque mise à jour par une estimation du carré moyen de son gradient. Il lui faut des pas, pas des tokens, pour que cette estimation se stabilise, et un taux plein avant cela fait des mises à jour démesurées. Muon fixe la taille de ses mises à jour par l'orthogonalisation, et la montée compte beaucoup moins pour lui. Une montée se compte donc en pas.
Et notre lot de 16 ?
Le lot de 16 séquences était un bon choix pour nos budgets : à tokens égaux, il est le meilleur des trois, et le lot de 64 n'est presque pas pire. Avec Muon, un lot de 64 aurait fait quatre fois moins de pas pour presque la même perte, et la carte traite mieux les gros produits : à budget de temps égal, il aurait sans doute gagné. Nous ne l'avons pas mesuré, la carte étant partagée pendant ces entraînements.
Muon tolère mieux les gros lots qu'AdamW : 0,005 contre 0,022 à 64 séquences, 0,10 contre 0,17 à 256. La première série avait un temps expliqué le retard de Muon par l'idée qu'il « suppose des lots énormes », avant de trouver que le retard venait surtout de son écriture. La mesure le confirme : il n'a pas besoin de gros lots. À notre lot, il bat AdamW de 0,036 nat par octet, et davantage encore quand le lot grossit.
Ce qu'il faut retenir
- Un lot plus gros fait moins de pas et, tant qu'il reste sous la taille critique, ne coûte presque pas de tokens.
- Le bruit du gradient, le rapport de sa variance à sa norme, estime cette taille sur un seul modèle : quelques centaines de séquences ici, à un ordre de grandeur près.
- À tokens égaux, nos lots de 16 et 64 séquences se valent ; 256 coûte cher, d'autant plus que l'entraînement est court.
- La montée du taux se compte en pas, surtout pour AdamW.
Article suivant : Prédire une nuit de calcul.